随着具身智能模型不断演进,模型本身的能力只是完整开发链路的一部分。对于一个新的 World Action Model(WAM)而言,从模型接入、训练,到推理和仿真评测,都需要一套能够快速适配并高效运行的基础设施。
RLinf 此前已经支持 DreamZero 等世界模型。此次,我们进一步将 NVIDIA 的 Cosmos 3 集成到 RLinf,并结合 SGLang 作为推理后端,打通从模型 SFT、推理服务到仿真评测的完整流程。基于 RLinf 完成 Cosmos3-Nano SFT,训练精度与官方实现对齐;并显著提升 Cosmos3 仿真评测吞吐,其中通过增强 SGLang 多 batch 推理及流水线并行评测,达到相比直接集成 SGLang 性能提升 3.33 倍的效果。
本文以此次的 Cosmos3-Nano 集成为例,介绍从模型微调到高效并行评测的全流程集成过程中的关键技术设计,以及 RLinf 如何通过流水化调度进一步提升模型评测效率。
01 Cosmos3:RLinf 的具身智能新考题
Cosmos3 是 NVIDIA 推出的全模态模型,能够原生理解和生成文本、图像、视频、环境声音以及动作,旨在为物理世界建模和动作生成提供统一的多模态能力。
在模型架构上,Cosmos 3 采用 Mixture-of-Transformers(MoT) 双塔结构,由自回归 Transformer 和扩散 Transformer 两部分组成。
自回归 Transformer 负责多模态信息的理解与推理;
扩散 Transformer 负责多模态内容生成。
两部分共享统一的注意力层以及 3D mRoPE(3D Multimodal Rotary Position Embedding) 位置表示,使模型能够在不同模态之间建立统一的时空表示,并实现跨模态的时空结构建模。
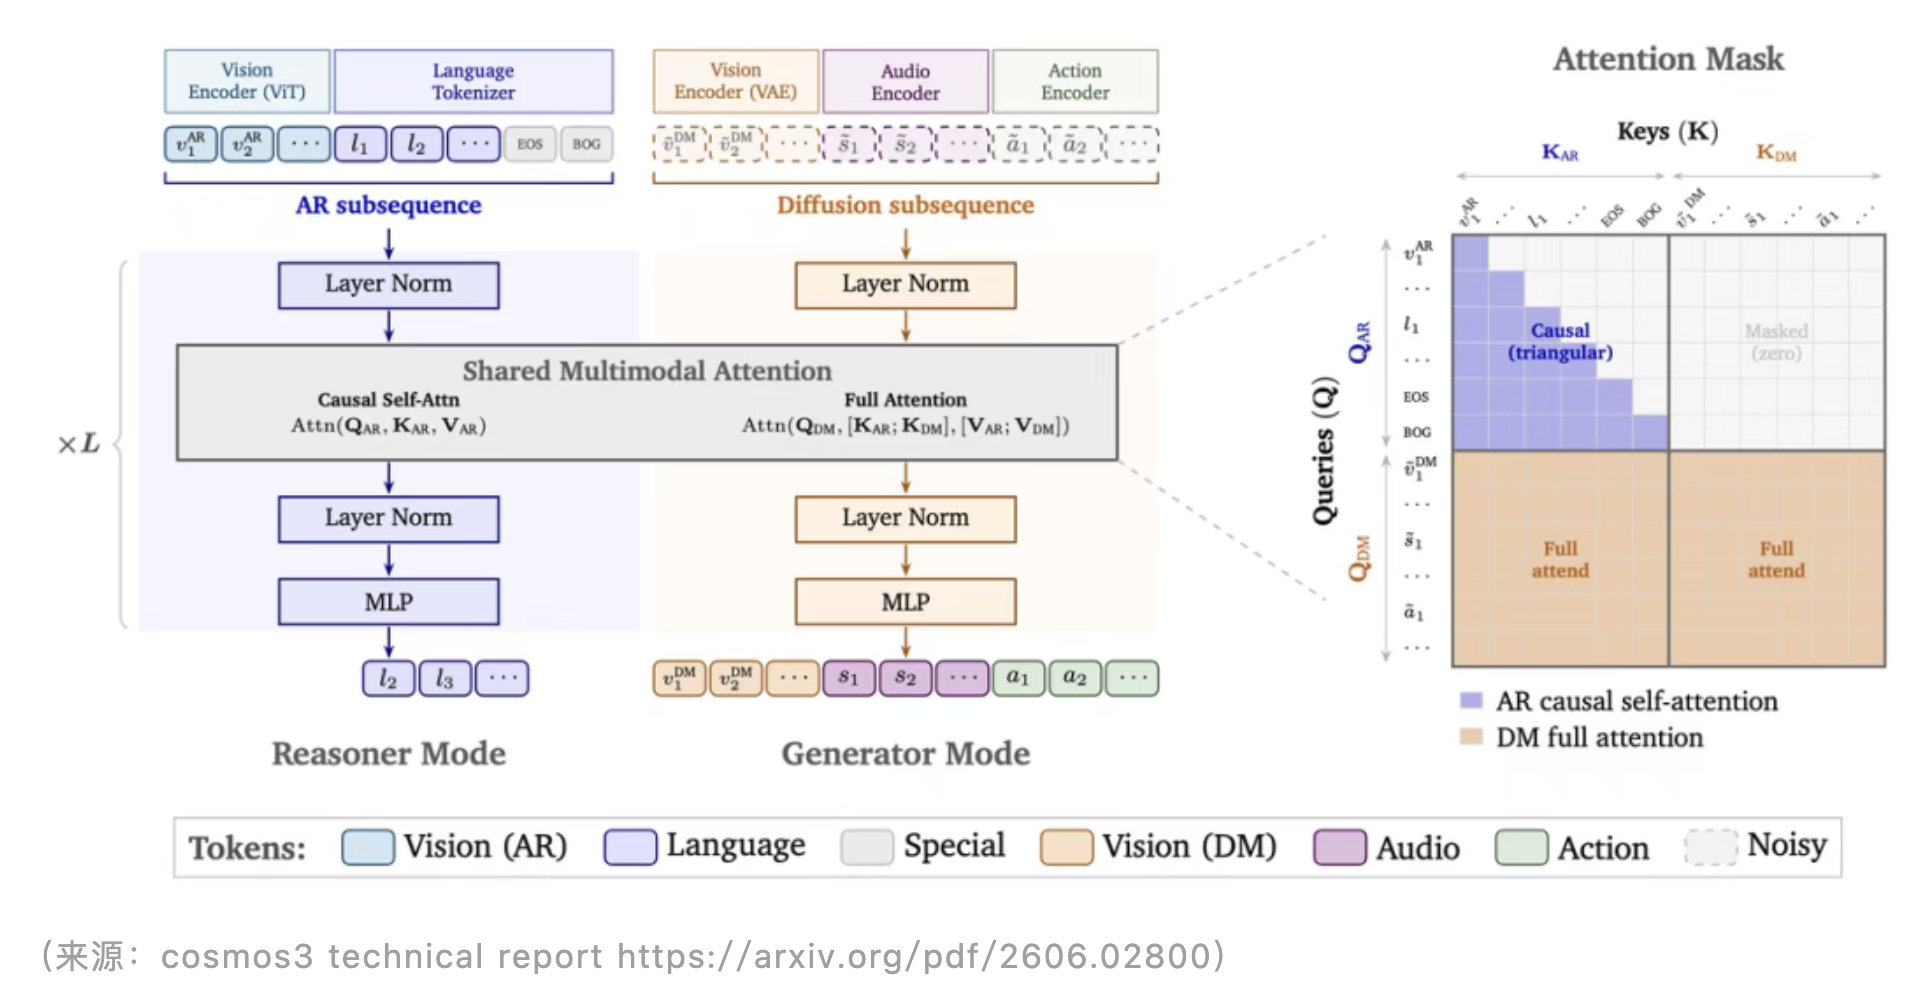
Cosmos 3 提供 Edge、Nano、Super 三种规格,本文后续训练与评测均以 Cosmos3-Nano 为例。
Cosmos3-Nano 是一个 16B 参数规模的 MoT 模型,其核心基于 Qwen3-VL-8B 的架构设计,包括 36 层 Transformer、4096 hidden size、32 个注意力头以及 8 个 KV heads。
在权重初始化方面,Cosmos3-Nano 并非完全从零训练:自回归 Transformer 模块直接复用 Qwen3-VL-8B 的预训练权重,扩散 Transformer 基于 Qwen3-VL-8B 的权重进行初始化,并在 Cosmos3 的训练阶段进一步优化。
当前 Cosmos3 在 RLinf 中的整体技术路线如下:
SFT 训练采用 RLinf 现有的 FSDP2 训练后端;
模型评测采用 SGLang 作为推理后端;
Cosmos3 是一个较为复杂的新型多模态/动作模型,将其接入现有具身智能的训练框架,本身就具有一定技术代表性。选择这样一个模型,也意味着 RLinf 需要面对的不只是一个常规模型推理任务,而是包含多模态理解、动作生成以及仿真评测在内的完整具身智能工作流。
02 模型微调:轻量化接入,复用 RLinf 训练基础设施
轻量适配接入,模型实现与训练基础设施解耦
Cosmos3 本身是一个 OmniMoT 模型,其模型结构已经开源于 NVIDIA 的 cosmos-framework 。而对于一个已经拥有完整官方实现的新模型,最大的集成成本之一,并不是“让它运行起来”,而是如何在接入现有训练框架的同时,避免重新维护一套模型实现。
在集成过程中,RLinf 并没有重写 Cosmos3 的模型结构,而是将其作为一个外部 Hugging Face Model,通过适配层接入 RLinf。
模型结构的构建与初始化仍由 Cosmos 自身的配置系统负责,RLinf 仅在模型外部增加一层轻量级封装,将 Cosmos3 的接口适配到 RLinf 的接口中。
Cosmos3 的 SFT 训练采用 RLinf 现有的 FSDP2 训练后端,不需要针对 Cosmos3 重新开发一套完整的训练流程,Checkpoint 保存与加载,以及日志与监控等能力,都可以复用 RLinf 现有机制。
这种设计的核心价值在于:能够最大程度复用 Cosmos3 官方实现,同时避免 RLinf 内部维护一套独立的 Cosmos3 模型代码。
这种模型适配和训练基础设施之间解耦的方式,也为后续模型扩展提供了更清晰和轻松的集成路径,模型接入可以复用已有训练能力,而无需改动 RLinf 的训练后端。
基于 RLinf 完成 Cosmos3-Nano SFT,训练精度与官方实现对齐
数据集采用 NVIDIA 开源的 LIBERO_LeRobot_v3 数据集。该数据集包含机器人操作任务的多模态轨迹数据,包括主视角和腕部视角的 RGB 图像、机器人状态(8D)以及对应的机器人动作(7D)。其中,机器人动作采用 3D 平移 + 3D Axis-Angle 旋转 + Gripper 的形式表示。
Cosmos3 在加载 LIBERO_LeRobot_v3 数据后,会在数据处理阶段在线完成 Action Representation 的转换与归一化。原始的 3D Axis-Angle 观测表示会转换为 6D Rotation Representation(Rot6D),原始 7D 动作会转换为 10D 动作表示,然后进行基于 Quantile 的归一化处理。
相比 Axis-Angle 表示,Rot6D 能够避免旋转在 ±π 附近的不连续问题,使动作空间具有更加平滑、连续的表示,有利于扩散模型更稳定地学习动作分布并生成高质量的机器人动作。
提示:
当前 SFT 实验使用的是 NVIDIA 官方提供的 LIBERO_LeRobot_v3 数据集,官方数据集的视频帧率为 10 FPS。如果后续更换其他 LIBERO 数据集或重新构建数据集,需要特别注意数据帧率等相关超参数是否与当前 Cosmos3 配置保持一致。
我们对当前RLinf 做cosmos3的 SFT 模型的 5000 iter 的实验结果如下(实验结果和 Cosmos3 官方实现 https://github.com/NVIDIA/cosmos 对齐):
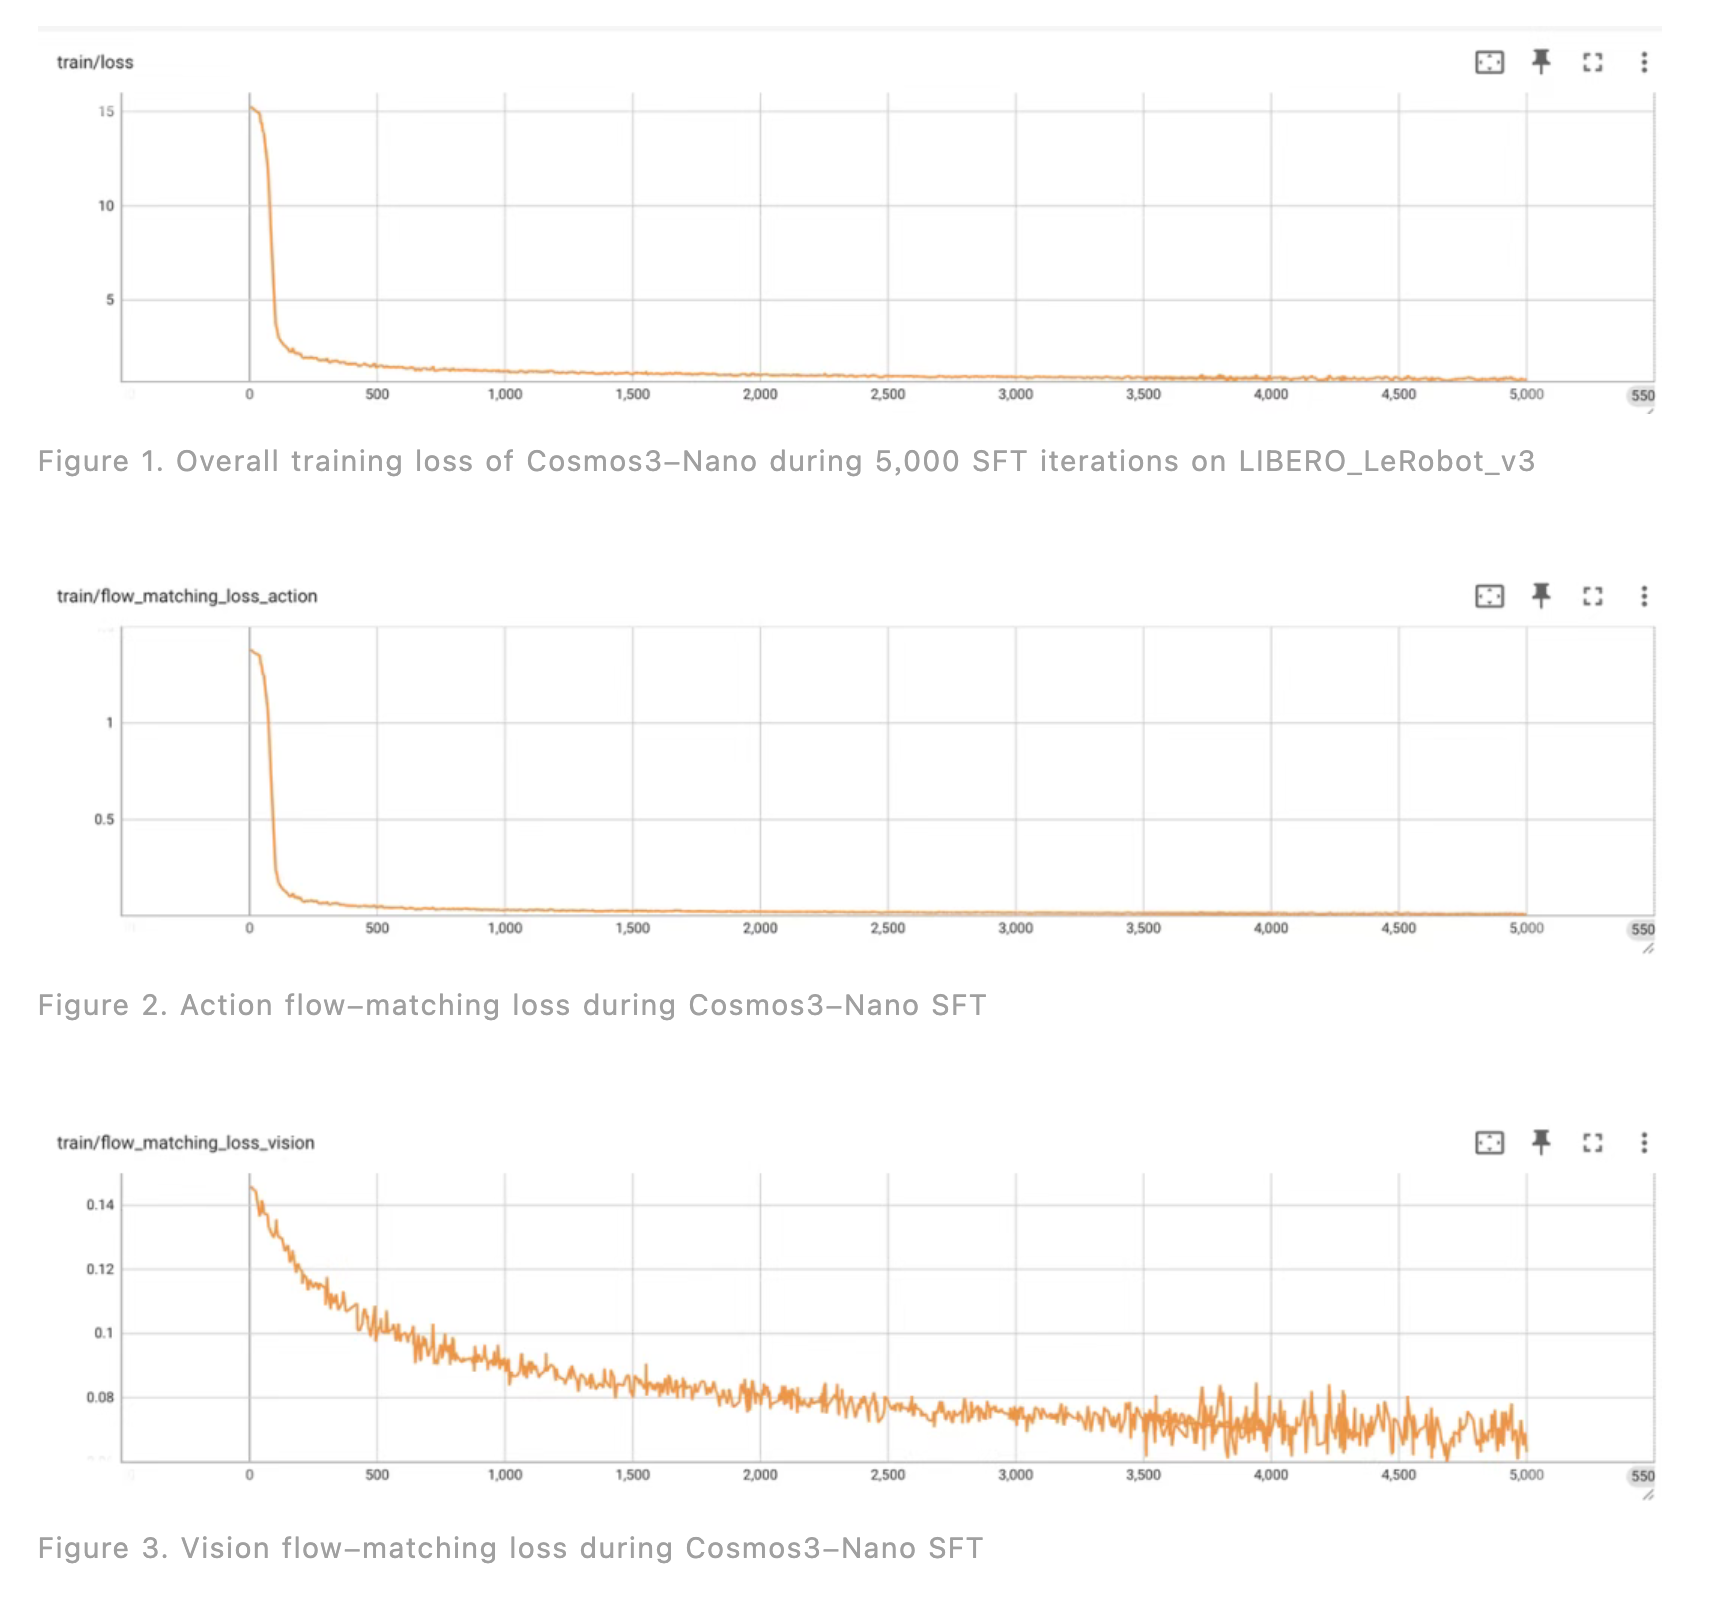
在 LIBERO_LeRobot_v3 数据集上进行 5,000 次 SFT 迭代后,Cosmos3-Nano 的总体训练loss呈现稳定收敛趋势。整体结果表明,目前 RLinf 上集成的 Cosmos3-Nano 能够有效学习 LIBERO 数据中的视觉与动作分布,并保持稳定的训练过程。
03 模型评测:调度解耦与流水协同,打造高效评测链路
完成 Cosmos3-Nano 在 LIBERO_LeRobot_v3 上的 SFT 后,需要进一步在仿真环境中对训练后的模型进行评测,以验证模型实际的机器人动作生成能力。
任务调度与推理调度解耦,让 RLinf × SGLang 各司其职
当前 RLinf 支持使用 SGLang 作为 Cosmos3 评测的推理后端,作为独立的推理服务负责模型的推理以及多请求并发处理。而 RLinf 对不同计算组件采用 Worker 进行统一管理,每个组件由对应的 Worker 负责其生命周期及组件间的数据交互。
这里有一个关键设计:RLinf 不去接管 SGLang 内部的推理调度。
SGLang 本身已经具备较为成熟的推理优化机制、内部 Router 和请求调度能力,如果 RLinf 再对其进行过多的生命周期管理或调度干预,反而可能破坏 SGLang 自身的调度机制,从而影响推理性能。
因此,RLinf 采用非侵入式的 SGLang Worker 架构:
RLinf:负责任务组织与数据流转
SGLang:负责推理与自身调度
SGLang Worker 在初始化阶段启动 SGLang 推理进程,在后续运行过程中主要负责 RLinf 与 SGLang 之间的数据适配和请求转发,并不介入 SGLang 内部的模型推理与请求调度。
当其他 Worker 发起推理请求时,SGLang Worker 首先对输入数据进行必要的格式转换,将其转换为 SGLang 所需的输入格式后直接发送至 SGLang 服务,并等待推理任务完成。推理结束后,SGLang Worker 获取模型输出,对输出数据进行格式转换,再将结果传递给后续 Worker。整个过程中,RLinf 不对 SGLang 内部的模型推理、请求调度及 Router 机制进行额外干预。
这样,RLinf 的任务调度与 SGLang 的推理调度被解耦:RLinf 管整体任务流,SGLang 管自己的推理效率。在完成系统集成的同时,也最大程度保留了 SGLang 原有的推理优化能力。
2. CPU 仿真与 GPU 推理并行,提高整体硬件利用率和评测吞吐
仿真和推理虽然属于同一条任务链路,却使用着不同类型的计算资源。在 Cosmos3 的 LIBERO 评测过程中,不同 Worker 的计算负载具有明显的异构性。例如,LIBERO 仿真器主要使用 CPU 执行环境仿真,而 SGLang 则主要使用 GPU 执行模型推理。如果采用完全串行的执行方式,仿真和推理两个阶段之间会产生明显的资源空闲,导致 CPU 与 GPU 无法得到充分利用。
因此,问题开始从“模型能不能跑”进一步变成:
如何让不同计算阶段真正协同起来?
针对这一问题,RLinf 在评测流程中提供了流水化执行机制。对于一批待评测任务,RLinf 会将任务进一步划分为多个 Batch,并通过多个 Pipeline 进行分批处理,使不同 Batch 可以在不同 Worker 上交错执行,从而尽可能重叠 LIBERO 仿真与 SGLang 推理阶段的计算负载。
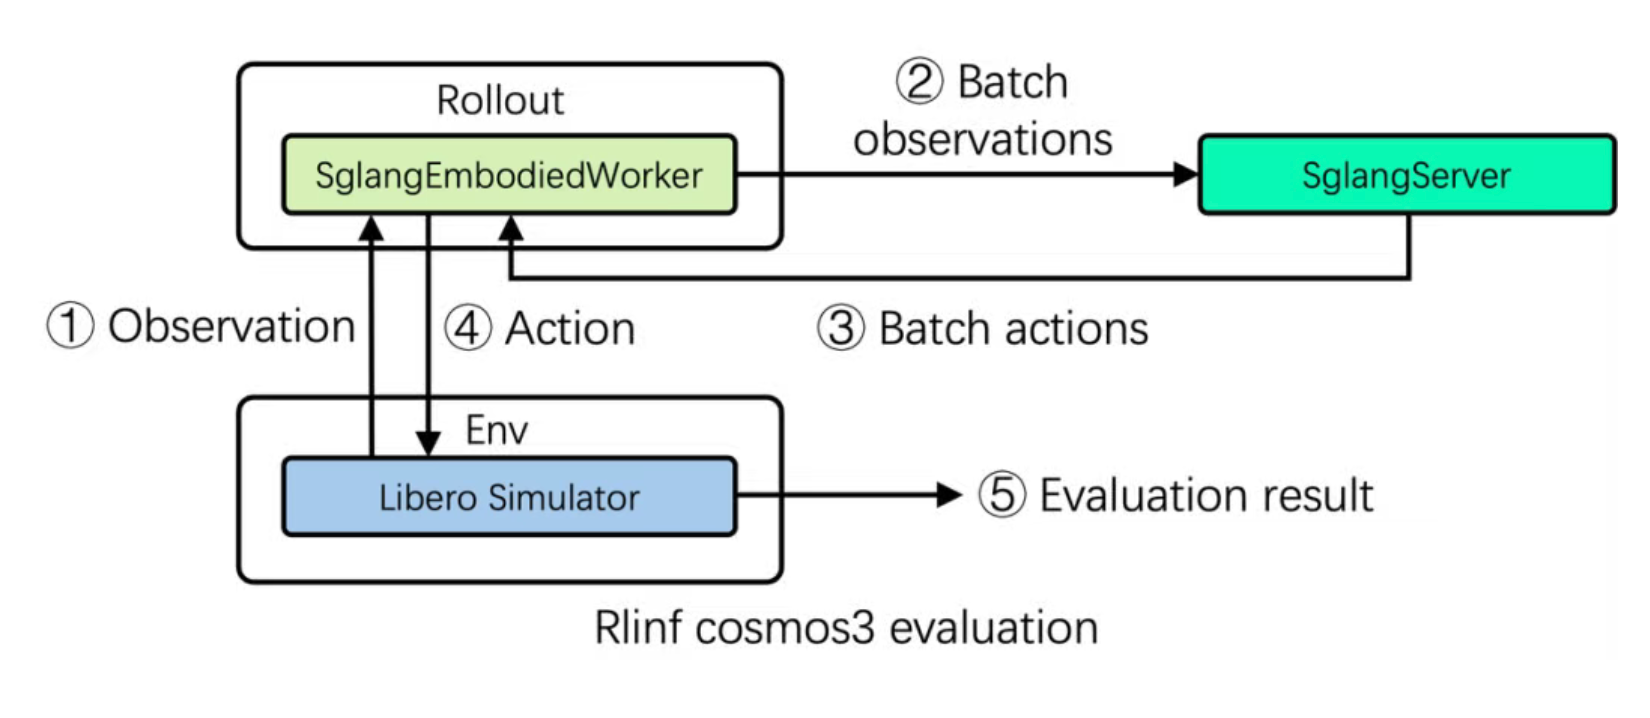
以 LIBERO-10 为例,在一台 8 卡 GPU 服务器上完成一次完整评测时,共包含 10 个任务 × 50 个 Demo,即 500 个 Episode。
RLinf 会启动 128 个并行仿真环境执行评测任务。每个仿真环境负责4个仿真任务的评估,当任务数量与并行环境数量无法完全匹配时,通过任务填充保证并行执行规模。当前配置下,8 张 GPU 平均分配 128 个仿真环境,即每张 GPU 对应 16 个仿真环境,从而实现仿真任务的并行执行。在此基础上,RLinf 可以进一步通过 Pipeline 将 128 个并行仿真环境划分为 N 个 Pipeline,每个 Pipeline 处理 128 // N 个仿真环境。每个 Pipeline 内部,任务按照 LIBERO 仿真 → SGLang 推理 → LIBERO 执行动作的流程循环执行;不同 Pipeline 之间则进行流水化调度。
LIBERO 仿真器首先并行推进对应环境,并获取当前时刻的观测数据。
RLinf 将多个环境产生的图像等观测信息组装为 Batch 后发送至 SGLang。
SGLang 利用自身的多 Batch、高并发推理能力同时处理多个请求,并生成对应的下一步 Action。
RLinf 获取推理结果后,将 Action 返回给对应的 LIBERO 环境执行,环境执行完成后产生下一时刻的观测,再进入下一轮推理。
通过这一过程不断循环,直至完成全部 Episode 的评测。
整个评测过程实际上形成了 LIBERO 并行仿真、RLinf Pipeline 调度以及 SGLang 高并发推理之间的流水化协同。CPU 侧的环境仿真与 GPU 侧的模型推理可以在时间维度上进行重叠,从而减少不同计算阶段之间的等待时间,提高整体硬件利用率和评测吞吐。
3. 实验结果:相对单 batch 吞吐最高提升至3.33×
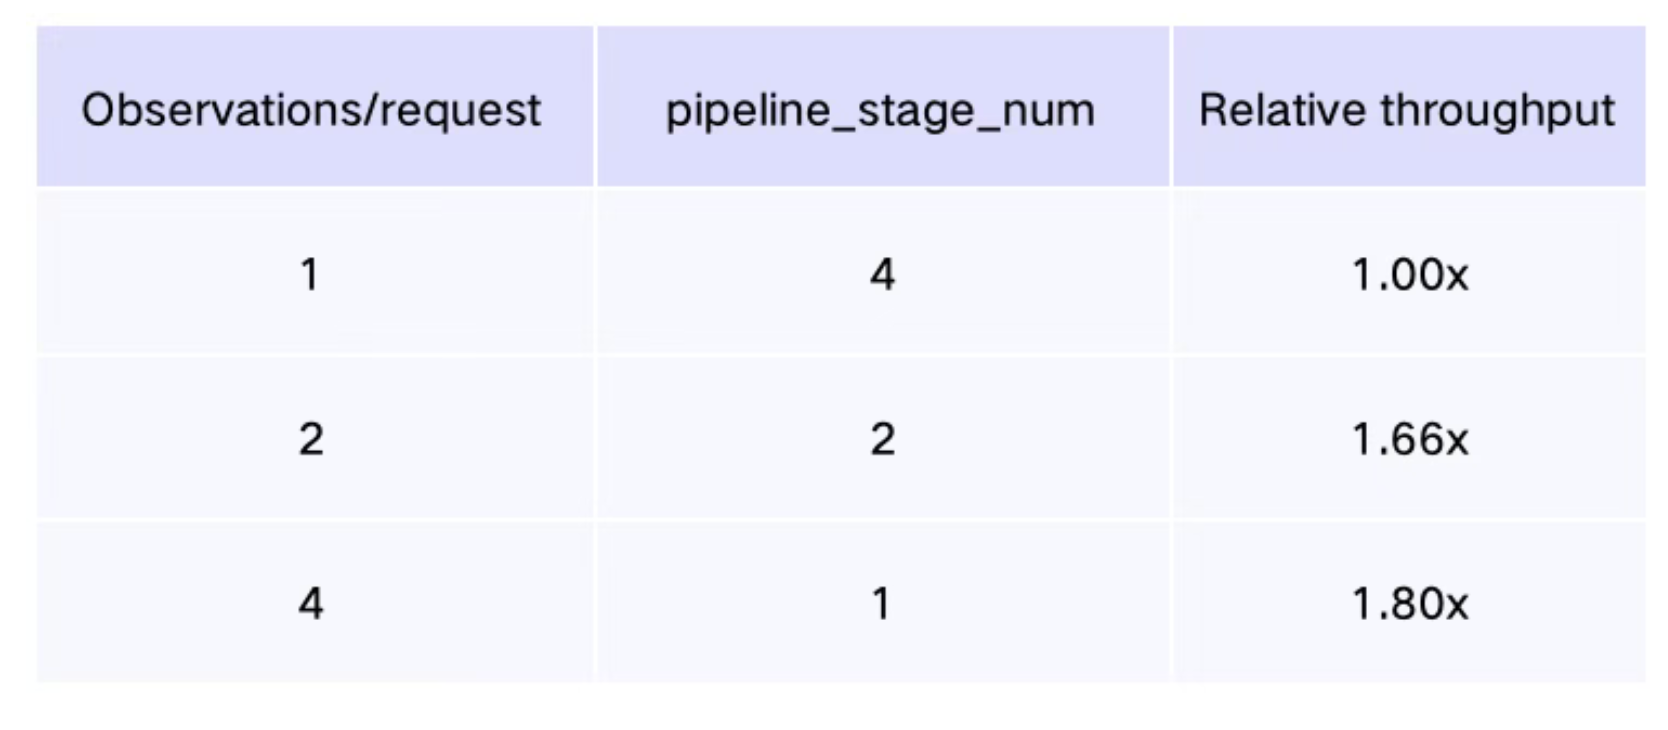
基于当前 Cosmos3 仿真评测任务,我们结合 RLinf 的流水化调度能力与 SGLang 的高并发推理能力进行了性能优化,端到端实验结果如下:
128 个 episode,32 个仿真环境
完整 500 个 episode,128 个仿真环境
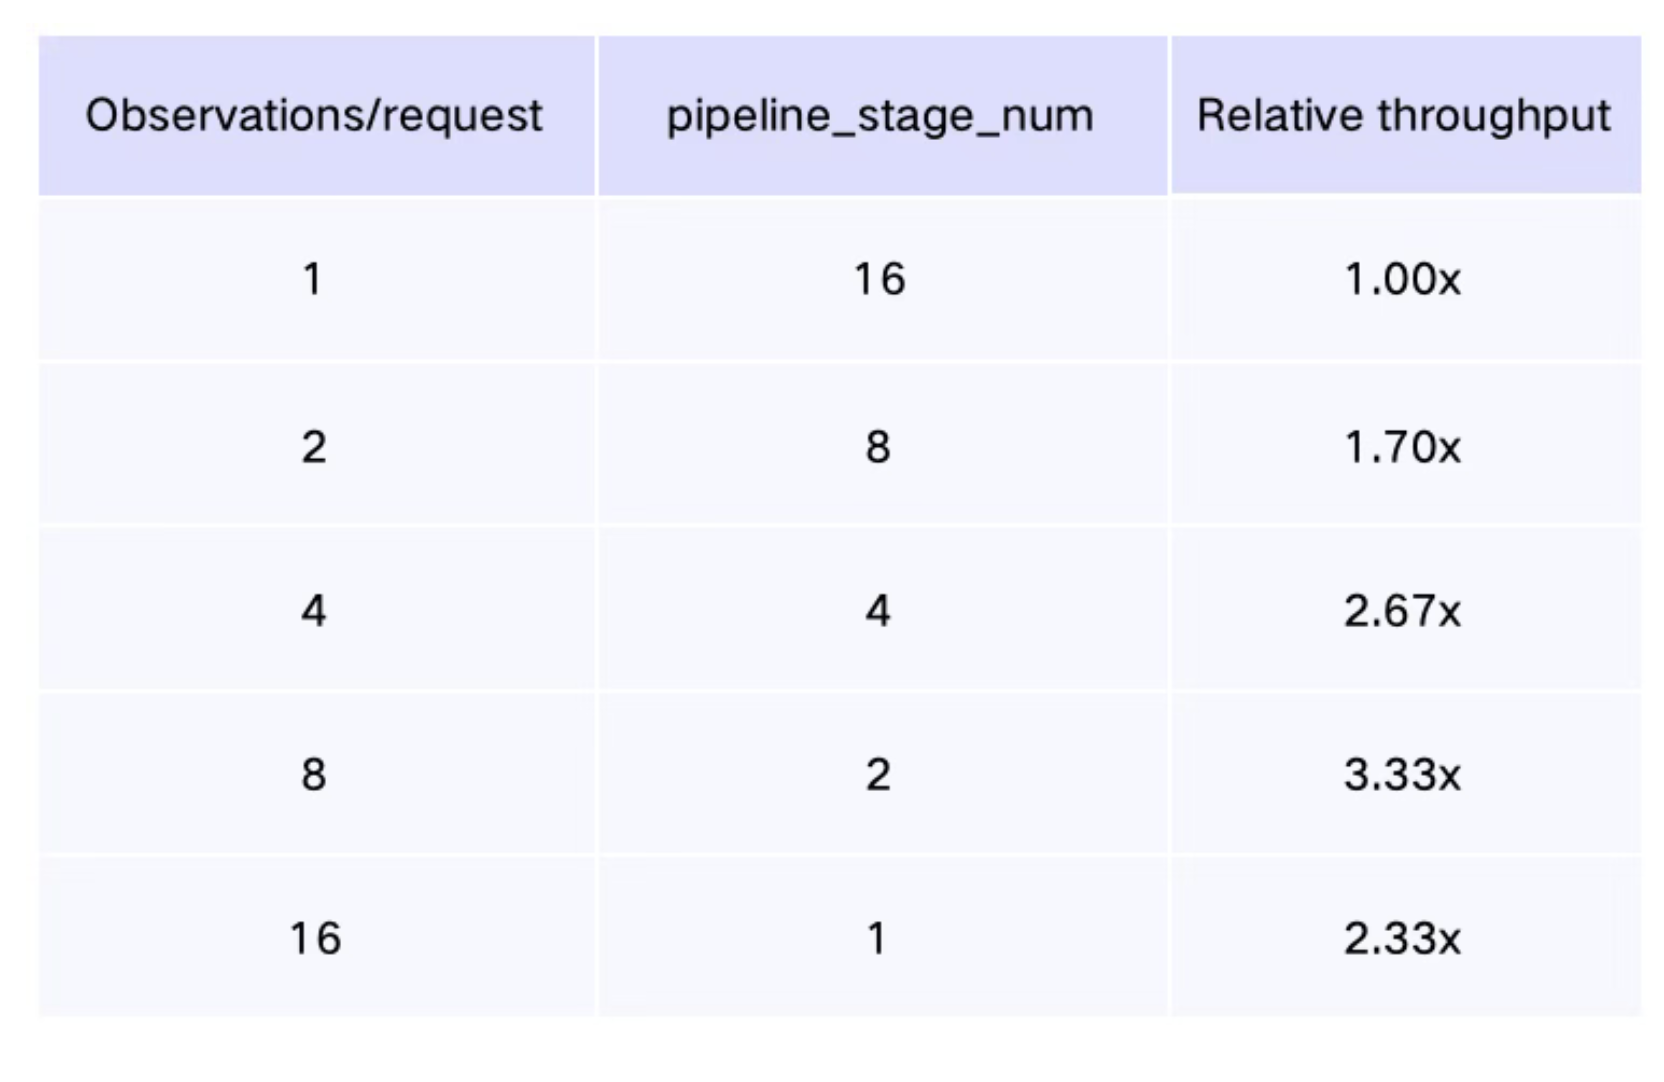
其中,表的第一列表示每个发给SGLang的请求中包含多少Observations,而pipeline_stage_num则表示分成多少个pipeline,两者的乘积需要是一个定值。实验结果表明,RLinf 流水化调度与 SGLang 高并发推理相结合,可显著提升 Cosmos3 仿真评测吞吐,其中完整 500 个 Episode 的评测最高达到单 batch 性能的 3.33 倍。
04 RLinf x SGLang x Cosmos3 :从“支持一个模型”到“打通一条完整具身链路”
Cosmos3 的集成并不只是让 RLinf “多支持了一个模型”。在此次实践中,Cosmos3 在 RLinf 中形成了从模型接入、SFT训练、SGLang 推理到仿真评测的完整流程。这套实践展示的并不只是对某一个模型的支持能力,而是 RLinf 面向不断演进的具身智能模型,如何以更轻量的方式完成模型接入,同时连接训练、推理和评测环节,并进一步通过系统级调度提升整体运行效率。
对于具身智能而言,基础设施的价值也不只是“把模型跑起来”。而是把模型、训练、推理、仿真以及任务执行组织成一套能够高效协同的完整系统,这也是 RLinf 持续构建具身智能与智能体基础设施能力的核心方向。
想了解更多请访问 https://github.com/RLinf/RLinf
期待您的点赞,关注和试用~
Cosmos3 SFT文档:https://rlinf.readthedocs.io/en/latest/rst_source/examples/embodied/sft_cosmos3.html
Cosmos3 SGLang Eval文档:https://rlinf.readthedocs.io/en/latest/rst_source/evaluations/guides/cosmos3_sglang.html