面向AI原生企业的大规模模型训练推理一体化平台
多种芯片统一纳管,异构异域异属万卡集群智能调度
万卡级规模高效稳定运行的模型训练
生产级大模型推理全链路优化平台
面向AI Native企业打造的一体化智能体运行与协同平台
面向具身智能“渲训推一体化”大规模强化学习框架
面向企业与开发者输出大规模AI智力的“Token工厂”
服务百余家行业头部客户,持续输出高质量、大规模、高效率的AI生产力。
为AI原生企业提供从模型开发到规模化商用的一站式AI基础设施平台与工程技术服务
为智能制造企业构建从知识沉淀到模型规模化应用的生产力底座
为AIGC及Al+应用企业构建从创意验证到规模化生产的创新加速引擎
以InfiniMizar推理加速引擎为技术核心,通过多模型x多后端适配能力,提供模组级、桌面式...
以M 种模型 x N 种芯片技术新范式与软硬协同、多元异构、自主式 AI 核心优势,实现多种模型算法与多种芯片硬件间的极致效率与成本优化。
统一调度不同架构的芯片实现对多样化算力的高效整合与协同
通过跨越软件与硬件的深度优化与联合设计极致挖潜芯片应用算力
以AI深度赋能AI,结合基础设施智能体蜂群让基础设施具备环境感知、决策行动与自进化能力
了解无问芯穹最新公司动态,技术突破、应用赋能、生态合作、产品发布……
AI效能跃迁纪 见证Token工厂进化论
探索媒体视角下的无问芯穹前沿AI技术
直击前沿现场 见证AI基建新范式
热门搜索
Cache-to-Cache
Token工厂
RLinf
具身智能工具链
多元异构
软硬协同
近日,无问芯穹联合清华大学、智元提出群体经验学习(Collective Experience Learning,CEL)范式,并在 96 台机器人上完成了原型验证。
近日,在 NVIDIA Research 推出的 GPU 算子性能评测榜单 SOL-ExecBench上,无问芯穹(Infinigence AI)取得亮眼成绩:先后登顶 L1 基础算子、L2 融合算子、Quant 量化算子与 FlashInfer-Bench 推理算子全部四大赛道。
无问芯穹与三体宇宙宣布达成战略合作。无问芯穹联合创始人兼CEO夏立雪、三体宇宙CEO赵骥龙共同发布首个合作成果——具有智子人格特征的AI对话Agent“智子Agent 1.0”。
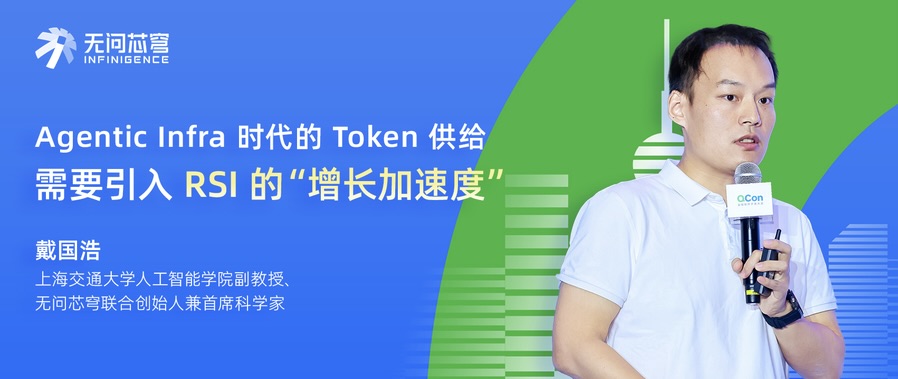
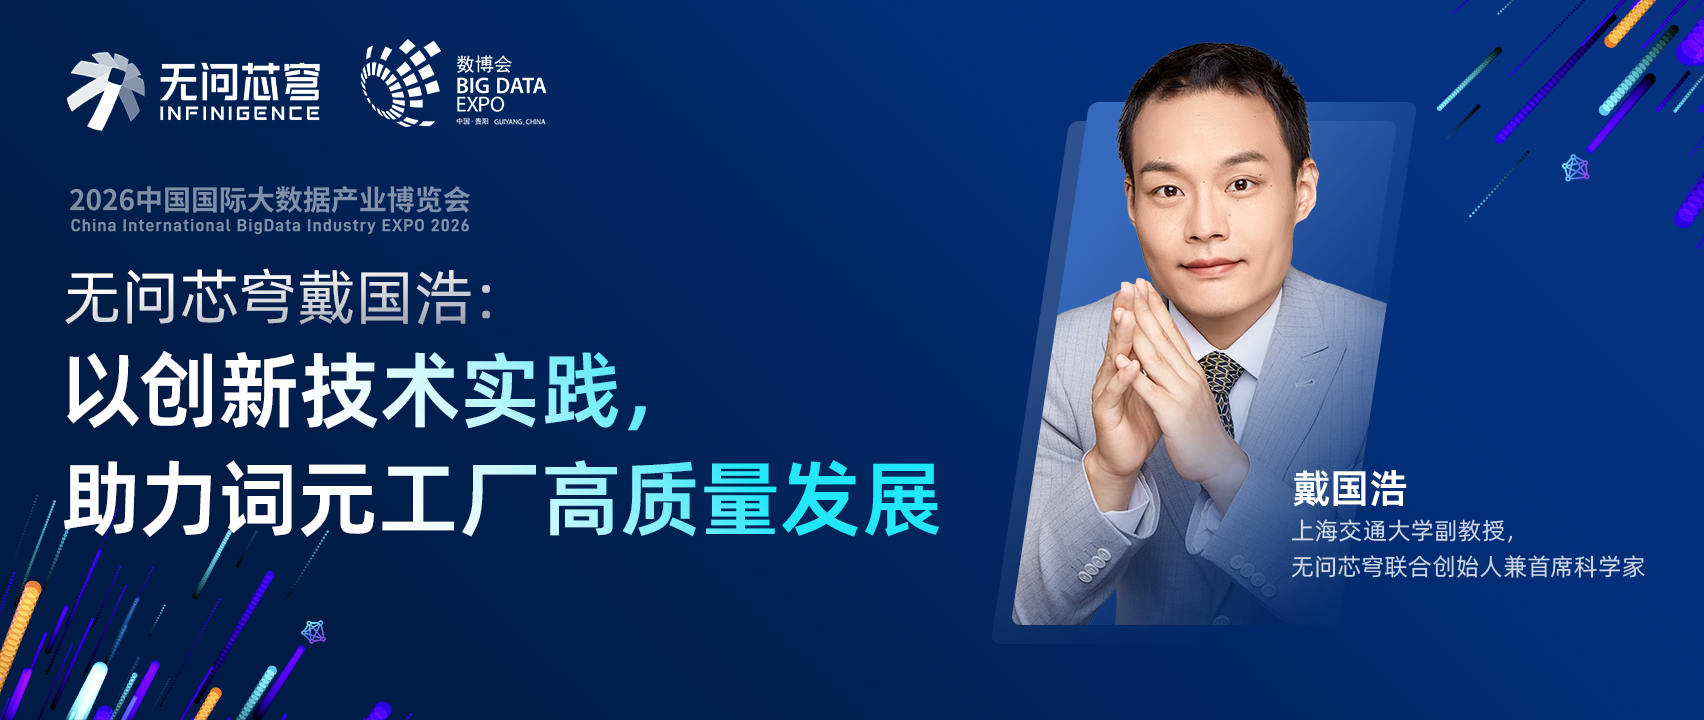
10 月 22 日,在 Qcon 全球软件开发大会上,上海交通大学人工智能学院副教授、无问芯穹联合创始人兼首席科学家戴国浩发表了题为《以 Agentic Infra 技术实践支撑词元工厂持续演进》的演讲。
近日,2026 人工智能开放计算大会暨众智 FlagOS 技术大会在北京举行,无问芯穹 CTO 李伯勋受邀出席具身智能专题论坛,并发表《具身智能开源基础设施迭代演进》主题演讲。
RLinf 与摩尔线程围绕具身智能强化学习展开合作,将 RLinf 的训练、推理与环境调度能力,与摩尔线程国产 GPU 及 MUSA 软件平台相结合,联合推进世界模型强化学习的工程适配、精度对齐与性能优化。
大模型头部企业与AI基础设施领军者的深度协同
由无问芯穹、清华大学联合北京中关村学院等多家机构共同研发的全球首个面向具身智能的大规模强化学习训练开源框架 RLinf,正式发布 v0.4 版本。
8 月 28 日至 30 日,由国家数据局主办、贵州省人民政府承办的中国国际大数据产业博览会在贵阳召开。
用智能进化智能,用生产力加速生产力
一架架飞机在空中有序飞行,按时起降,看似只是飞机自己的事情,实际上,它需要持续与机场、跑道、航线以及地面资源系统协同。
9月21日,以“智链世界,AI引领生命科学新未来”为主题的 2026 腾冲科学家论坛曼谷专题活动在泰国湄南河畔正式开幕。
Codex、Claude Code 等数字世界智能体已经向我们展示出一种全新且高效的工作方式
近日,2026 算力网发展大会在北京召开。作为大会重要组成部分,由中国信息协会算力网专委会、无问芯穹与北京迪盛数智科技有限公司联合主办的“面向物理 AI 时代的算电基础设施”分论坛同期举行。
为降低机器人强化学习奖励建模成本、提升跨任务复用能力提供新的技术路径
联系我们,获取定制化 AI 基础设施解决方案
我们将使用Cookie以便更好了解您对本网站的使用情况。这将有助于改善您今后访问本网站的体验,关于Cookie的使用,以及如何撤销或管理您的同意,详见我们的《隐私政策》,如你点击确认按钮,将视为您同意Cookie的使用。
必需Cookie无需同意,其他Cookie需您自主选择。您可随时在「Cookie设置」中撤回同意。