具身智能的发展对强化学习训练提出了更高要求。RLinf 与摩尔线程围绕具身智能强化学习展开合作,将 RLinf 的训练、推理与环境调度能力,与摩尔线程国产 GPU 及 MUSA 软件平台相结合,联合推进世界模型强化学习的工程适配、精度对齐与性能优化。
RLinf 由无问芯穹和清华大学联合北京中关村学院等多家机构共同推出,是全球首个面向具身智能的大规模强化学习训练开源框架,被多所世界顶尖高校学术机构以及全球领先的AI 芯片和具身智能等企业广泛采用。 本次实践以 RLinf 为基础,将 WoVR 的世界模型强化学习训练链路迁移至摩尔线程 MUSA 软件平台与 S5000 加速卡,完成了单机 8 卡和双机 16 卡验证,覆盖平台适配、训练精度对齐与系统性能优化。
在这条训练链路中,OpenVLA-OFT 生成动作,Wan 世界模型预测后续画面,奖励模型评估任务完成情况,RLinf 则负责协调各模块运行,并通过 GRPO 更新策略。适配的关键,是让策略训练、推理与世界模型在统一的设备管理和调度机制下稳定协作,形成完整的强化学习训练闭环。
验证结果显示,191 步训练成功率曲线相关系数为 0.976,第 190 步 S5000 与 国际主流GPU分别为 74.6% 和 73.4%;性能优化方面,8 卡推荐配置将整步耗时从2110.7 s 降到 1887.6 s(-10.6%),双机 16 卡 hybrid_shard 将整步从 824.8 s 降到 698.6 s(-15.3%),权重同步从 278.9 s 降到 93.7 s(-66%)。
本文围绕此次实践,分享 RLinf 承载世界模型强化学习训练的关键机制,以及在国产 GPU 上实现稳定运行、精度对齐与性能提升的工程经验。
1. RLinf 如何承载 WoVR 的训练闭环
RLinf 的关键抽象是 Worker、Scheduler 和 Channel。Worker 承载环境、策略推理和参数更新;Scheduler 决定它们放在哪些 GPU 上;Channel 负责轨迹、梯度和权重在进程组之间流动。对 WoVR 而言,一次训练 step 的数据流可以简化为:
OpenVLA-OFT (rollout) │ 8 步动作 chunk ▼Wan world model (env) ──> 后续画面 + reward │ │ └─── trajectory ─────┘ ▼ GRPO / OpenVLA-OFT (actor) │ └── 每 step 同步新权重
env、rollout 和 actor 是三个逻辑角色,但不必对应三组固定 GPU。RLinf 提供三种执行布局:
• 共享式:三个角色轮流使用同一批 GPU,通过 offload 释放暂时不用的模型;配置简单, 但最慢的 rollout 会拖住整步。
• 分离式:角色各自占用 GPU,减少让位和搬运;数据依赖会造成部分 GPU 空转。
• 混合式:env 与 rollout 分组流水,actor 再使用完整 GPU 组;生产和消费通过队列 解耦,适合吞吐优先的训练。
本次复现采用共享式布局。它把显存和通信问题集中到一台机器上,也让每个适配改动都能通过同一条端到端链路验证。
2. MUSA 适配:从设备识别到训练闭环
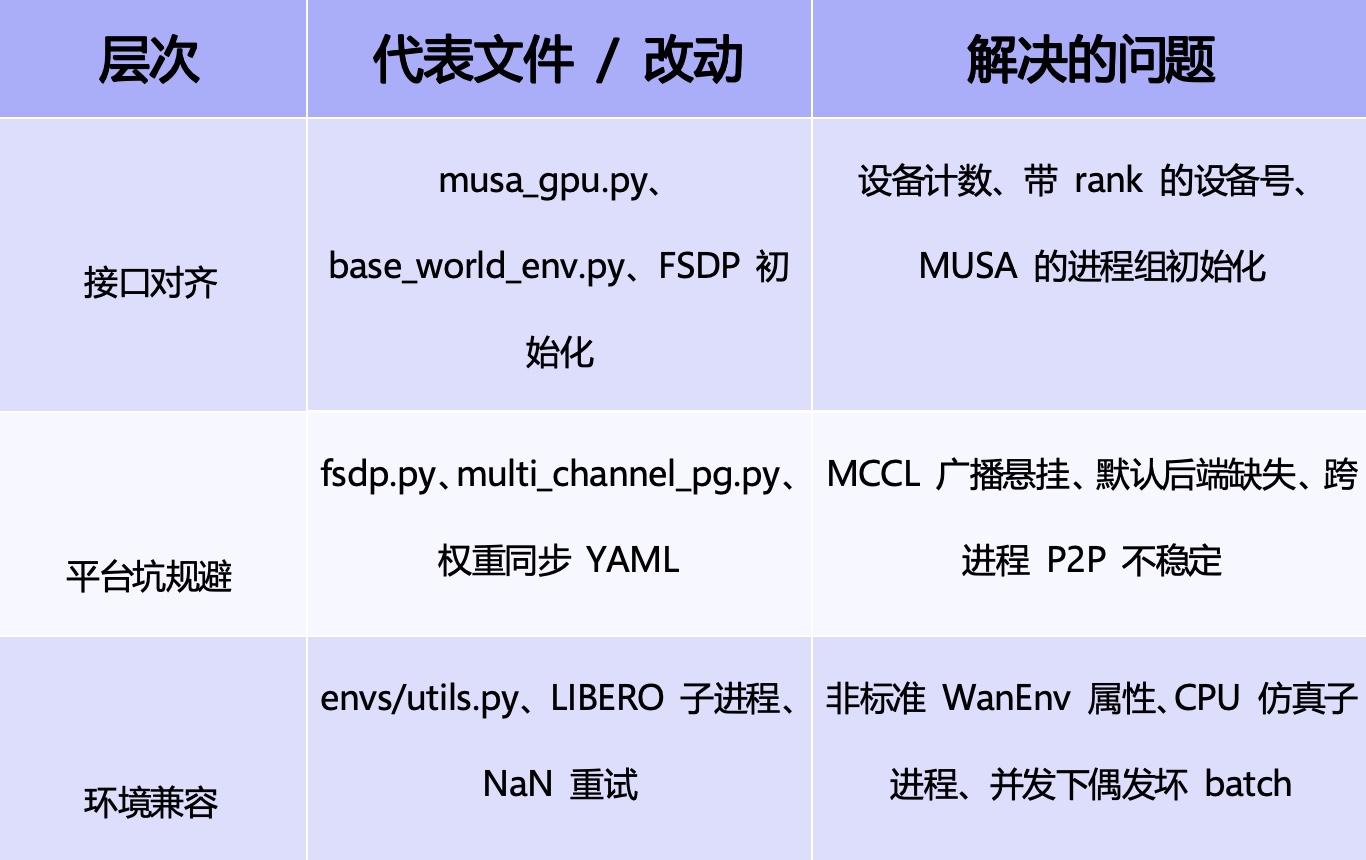
适配以 RLinf 上游基点 4677808a 为参照。改动分成三层:接口对齐、平台问题绕行和可独立开关的性能优化。默认配置仍保留原行为,性能改动通过配置或环境变量显式开启。
主要改动与对应边界
3. “能跑起来”之前的五个坑
适配的第一阶段不是调吞吐,而是让程序正确识别设备并完成初始化。
3.1 设备计数不能只依赖 pymtml
RLinf 原先通过 pymtml获取加速卡数量。目标容器中该 Python 绑定不可用,且 PyPI 上存在同名包,结果会被误判为 0 张 GPU。musa_gpu.py 现在保留原查询,失败时回退 到 torch.musa.device_count()。这类回退只解决“看见设备”,不负责进程级设备分配。
3.2 WanEnv 不是标准 gym 环境
上游 get_env_attr 优先调用 get_wrapper_attr。Wan 世界模型环境不是标准 gym 包装器,调用会抛出 AttributeError,异常又被误认为属性不存在。修复方式是在该路径失败时回退到普通 getattr,保留包装器的 __getattr__ 委托行为。
3.3 设备隔离必须放在容器边界
RLinf 的 rank 逻辑默认进程看到的是本地连续设备。若在进程内部把 MUSA_VISIBLE_DEVICES 重写成 0,MUSA 会把它解释成物理 0 号卡,进程可能跑到别人的卡上。本次运行通过容器层的 MTHREADS_VISIBLE_DEVICES 限制可见卡,保留 RLinf 自己的 rank bookkeeping。
3.4 MUSA 需要显式的双后端
MUSA 进程组使用 MCCL,但 checkpoint 的 sharded state dict 路径还需要 CPU 的 Gloo。 代码在创建设备 mesh 前显式初始化:
dist.init_process_group(backend="cpu:gloo,musa:mccl")
这对应 CUDA 环境中通常自动存在的 CPU 后端,不能因为设备是 MUSA 就省略。
3.5 OpenVLA-OFT 的注意力方向必须一致
OFT 训练依赖双向注意力,而未应用 OpenVLA-OFT 定制补丁的上游 Transformers 4.40.1 默认按 causal attention 执行。 在同一训练配置下,修复前 S5000 的第一步成功率为 0;补上 is_causal=False 与纯 padding mask 后,S5000 为 0.516,国际主流GPU对照为 0.469。这不是精度微差,而是策略分布被改变后动作接近随机,GRPO 没有有效训练信号。
4. 权重同步:真正的通信难题
训练组和 rollout 组之间每个 step 要传输约 15 GB 的新权重。问题不是单个 isend能否完成,而是多进程共享 GPU、MCCL 和 RLinf 的进程隔离叠加后,端到端传输会出现崩溃、自旋或超时。
我们按“最小复现 → 端到端重放”的顺序排查:同卡 IPC 和跨卡 isend/irecv 的孤立探针可以通过,但 8 卡并发设备直传仍会触发 llaunch timed out。因此,不能把孤立探针通过当作生产链路稳定的证明。
最终采用的稳定路径是让权重经过 CPU 内存:
actor GPU ──> CPU buffer ──> CPU/Gloo ──> rollout CPU ──> rollout GPU
配置为 transport_device: cpu。它多绕了一次拷贝,但每步只发生一次,而且 15 GB 权重可以分片并行传输。冒烟口径下同步约 41 s,官方整步约占 2%;在共享式训练里, 世界模型想象和 VLA 推理仍是主要耗时。
为减少 MCCL 风险,我们还做了两项边界修复:
• 由于每个 rank 已经独立加载同一份 Hugging Face checkpoint,关闭 sync_module_states,避免 7.5B 模型的 coalesced broadcast 悬挂;
• 公开版本不依赖未发布的额外通信库,权重同步直接使用配置中的 CPU/Gloo 路径, 集合通信仍使用 MCCL。
5. 显存布局与数值语义
共享式布局下,训练模型、推理模型和世界模型同时常驻会超过 80 GB。解决方式不是盲目缩小 batch,而是按角色让模型轮流驻留:
• 世界模型在 env 进程中常驻,约占 24.9 GB;
• rollout 阶段不推理时,把推理模型整体 offload 到 CPU;
• env 生成画面时,训练模型的参数和优化器状态 offload,训练阶段再搬回。
该布局允许 8 卡正式训练。公开配置将训练、推理和环境模型的驻留时机错开, 并通过 offload 控制峰值显存;micro batch 仍需根据节点显存逐档验证。
并发运行还暴露了偶发的批行级 NaN。当前代码在 VLA 前向和 Wan 前向检测到 NaN/Inf 后整批重算,最多重试 3 次;独立重放未再复现时,这属于平台运行时的保护壳,不应被误解为算法稳定性证明。LIBERO CPU 子进程则在创建前清空 MUSA 可见设备,避免无用的设备上下文放大驱动初始化竞态。
6. 世界模型快路径:减少搬运但保持逐位一致
S5000 的矩阵乘和注意力并不是主要瓶颈。原始 Wan 环境每生成一段画面,会在 CPU 与 GPU 之间往返搬运大量小张量:输入图像经过 PIL / NumPy,VAE 输出又逐帧回到 host。我们把这些路径合并成 WOVR_FAST_IO:
• 输入条件帧留在设备上,去掉逐帧 PIL 往返;
• 去噪循环的 finite 检查从每轮多次同步降到整轮一次,NaN/Inf 仍触发重试;
• DiffSynth 侧把热路径 Python 标量提升为 0 维设备张量。
这里不能只看“数值误差很小”。视频帧会量化回 uint8,一次 1 ULP 差异会在自回归 反馈中被放大。为保证与原始 NumPy 路径相同,代码在 host 上预计算 256 项 uint8 uint8 -> [-1, 1]查找表,设备端只做索引。国际主流GPU 与 S5000 的 2044 万个元素逐位对比均为 0 差异。
在 8 卡公开配置中,世界模型 env 交互耗时约从 2050 s 降到 975 s;不开性能开关时,完整训练整步约为 3100 s,开启后约为 1900 s。这组优化只改变数据搬运和同步路径,不改变训练语义。
7. 单机验证:精度对齐与训练提速
7.1 训练曲线和外部评测
最终效果使用 LIBERO 仿真器评测,而不是直接把世界模型内部 reward 当成成功率。 真机训练起始精度为 S5000 55.0%、国际主流GPU 59.7%; 第 190 步读数为 S5000 74.6%、国际主流GPU 73.4%;差异检验为 p=0.76, 在这次实验窗口内没有统计显著性。
7.2 推荐配置的 A/B
公开配置 perfA 中,actor.micro_batch_size 设置为 32,
actor.fsdp_config.enable_gradient_accumulation设置为 False global_batch_size 保持为 8192。与公开的 wan_spatial_official_s5000.yaml 相比,仓库中可追溯的配置差异是关闭梯度累积。下面的耗时数据来自 8 卡同机、同数据的实测 A/B;配置文件用于说明 perfA 的设置,不能据此反推未保留在仓库中的历史配置。
8 卡同机、同数据的 3 步平均
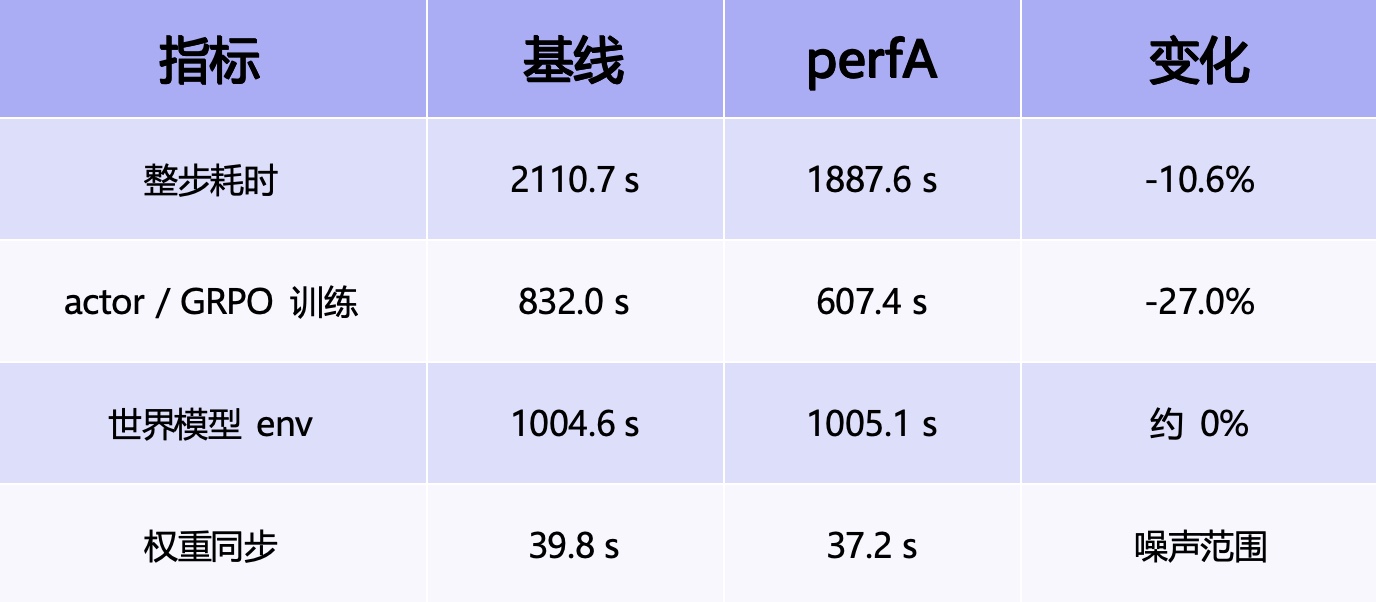
结果说明本轮提速主要来自训练阶段的 micro-step 固定开销下降,世界模型仍占整步约 一半。它是可独立回滚的配置实验,不代表所有模型或多机网络都适合关闭梯度累积。
8. 双机 16 卡:把跨机通信留在必要的边界
从单机扩展到两台 8 卡机器后,新增了三个与算法无关的系统问题:
1. 16 个进程同时第一次触碰 MUSA 会触发驱动惰性初始化竞态,表现为无日志挂死;
2. RDMA userspace 缺失时,MCCL 会静默回落 Socket,带宽问题容易被误判成代码故障;
3. hybrid_shard 需要二维设备 mesh,上游代码只创建一维 mesh,且 FSDP1 的梯度范数 需要限制在节点内分片组中归约。
当前实现用 WOVR_DEV_INIT_STAGGER=3 按 rank 错峰初始化,用 WOVR_FSDP_SHARD_SIZE=8 创建 (节点数, 每节点卡数) 的二维 mesh,并让 hybrid_shard 在机内完成参数 all-gather,跨机只承担必要的梯度归约。
双机实测结果如下。

这组结果的关键不是“多了一种 FSDP 策略”,而是把大块参数聚合从约 4.7 GB/s 的跨机 链路收回到机内。错峰初始化、容器任务数上限、RDMA/网络配置和 Ray 集群清场都属于 启动前提;缺少其中任何一项,不能把失败归因给 hybrid_shard 本身。
9. 结语:适配的边界与下一步
这次工作把 RLinf 的 WoVR 训练链路带到了摩尔线程的 MUSA 软件平台与 S5000 加速卡:框架层补齐设备和双后端接口,通信层采用 CPU 中转与 MCCL 集合通信,显存层通过角色级 offload 支撑共享式布局,性能层用设备内快路径和二维 hybrid-shard 减少无效搬运。精度、单机性能和双机扩展均有对应的实测证据,但它们来自不同配置和窗口,应该分开复现和报告。
当前仍有明确的工程边界:断点续训路径和部分驱动初始化问题仍需独立验证,部分 NaN 保护和 CPU 权重同步属于平台稳定性绕行。后续工作应继续压缩世界模型的生成开销, 并在驱动和通信库修复后重新评估设备直传路径。
*数据来源:摩尔线程实验室
参考资料
• RLinf 文档与代码
• WoVR: World Models as Reliable Simulators for Post-Training VLA Policies with RL