具身智能正加速从仿真环境走向真实物理世界,如何突破真机训练效率、软硬件适配及系统部署等关键瓶颈,正成为推动机器人规模化应用的重要课题。
由无问芯穹、清华大学联合北京中关村学院等多家机构共同研发的全球首个面向具身智能的大规模强化学习训练开源框架 RLinf,正式发布 v0.4 版本。
从 v0.1、v0.2 逐步建立强化学习系统抽象与真实世界在线学习基础设施,到 v0.3 打通仿真训练与真实机器人部署的基础链路,RLinf 持续完善具身智能强化学习的全链路技术能力。此次发布的 v0.4 进一步聚焦真实物理场景下的强化学习需求,围绕“乐高式真机系统 + 高效率真机算法 + 全模态模型支持 + 国产算力底座”四大核心方向展开系统性迭代,重塑了真机强化学习的工程与算法范式,推动具身强化学习从技术验证走向更高效、更灵活、可复现的真实机器人应用。
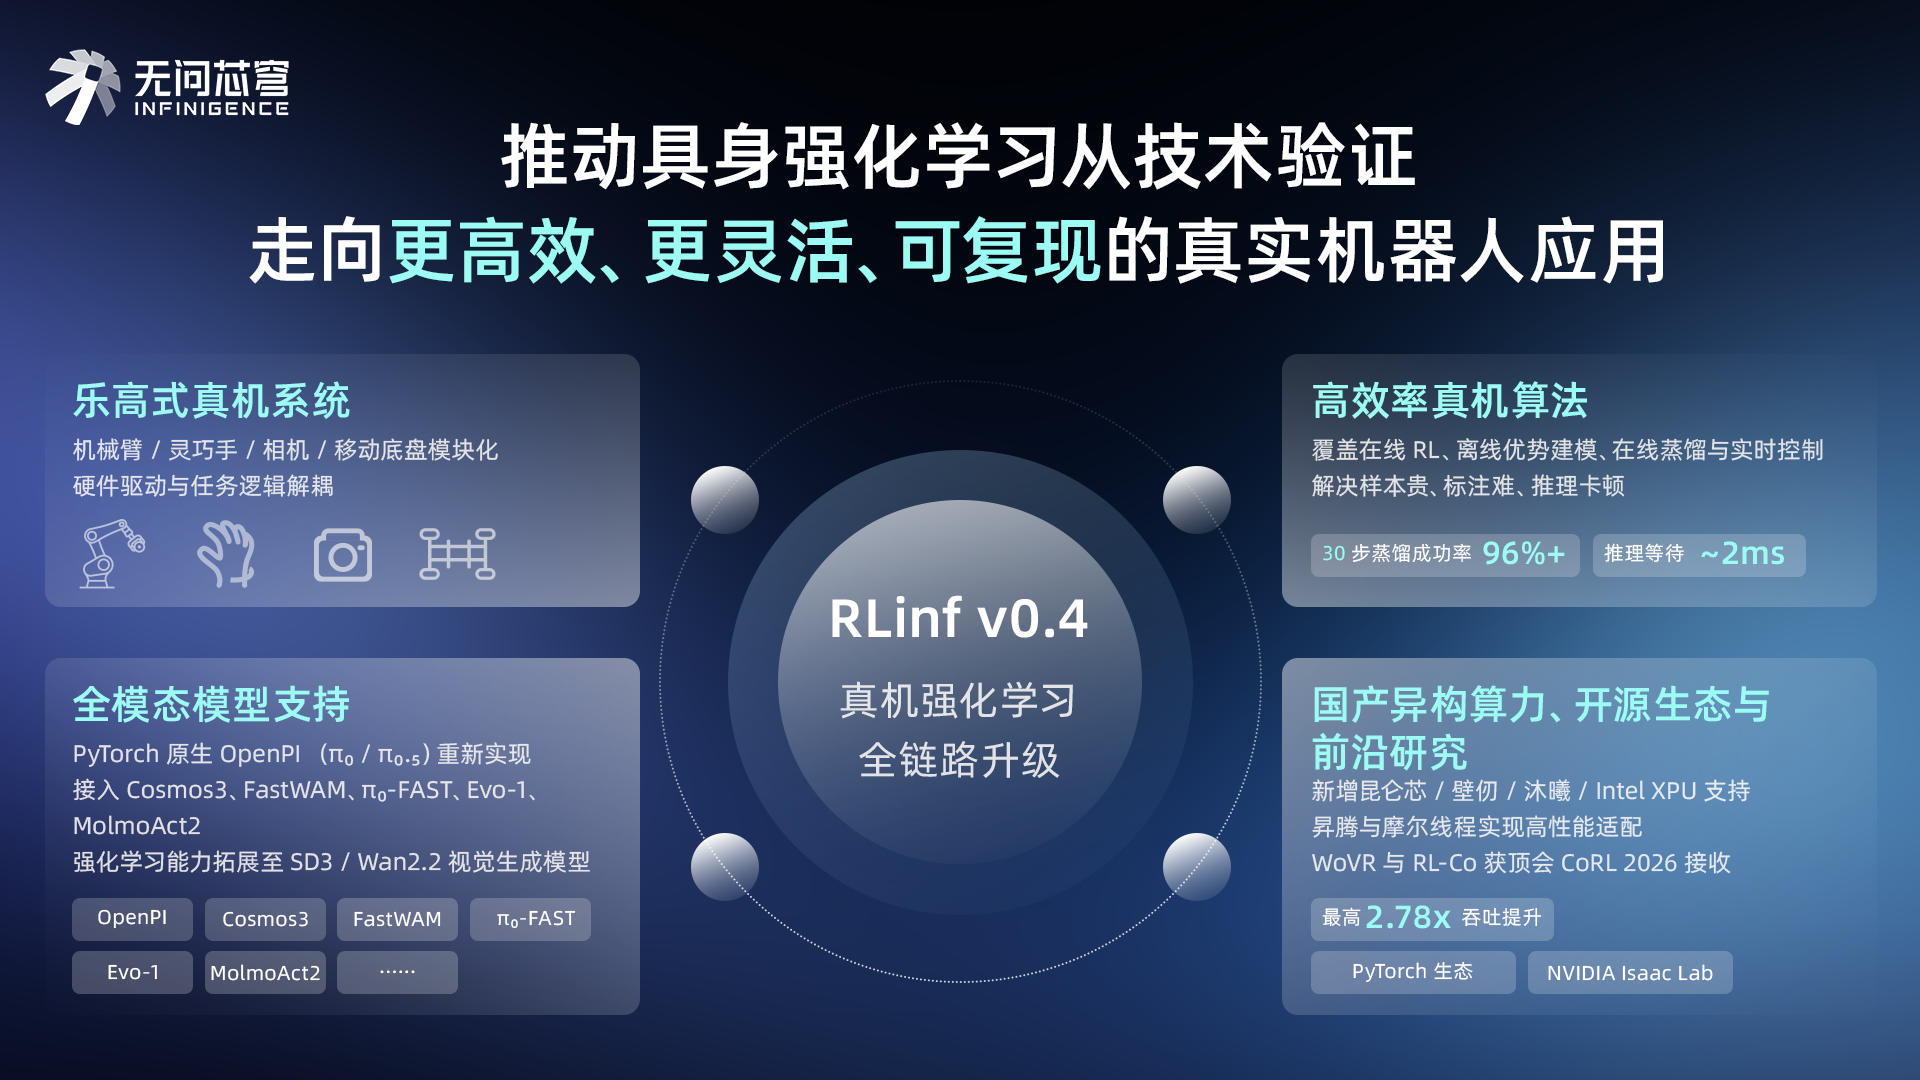
乐高式真机工程体系(rlinf.robotics):将机械臂、灵巧手、相机、移动底盘与遥操作外设抽象为即插即用的“乐高积木”,实现硬件驱动与任务逻辑彻底解耦——无论是换本体、改构型还是跨节点部署,上层任务与策略代码均“零改动”。
真机 SOTA 后训练算法矩阵:推出表征解耦在线强化学习(RLT)、零标注自监督离线强化学习(STEAM)、30 步成功率跃升至 96%+ 的在线策略蒸馏(OPD),以及将推理等待压缩至 ~2 ms 的异步实时控制(RTC),正面攻克真机样本贵、标注难、推理卡顿三大痛点。
全模态模型重构与扩展:从底层重写与官方 JAX 逐算子数值对齐的 PyTorch 原生 OpenPI(π₀ / π₀.₅),一口气接入 NVIDIA Cosmos3、FastWAM、π₀-FAST、Evo-1、MolmoAct2 等 5 款前沿世界动作模型与 VLA,并将强化学习能力首次拓展至 SD3 / Wan2.2 视觉生成模型。
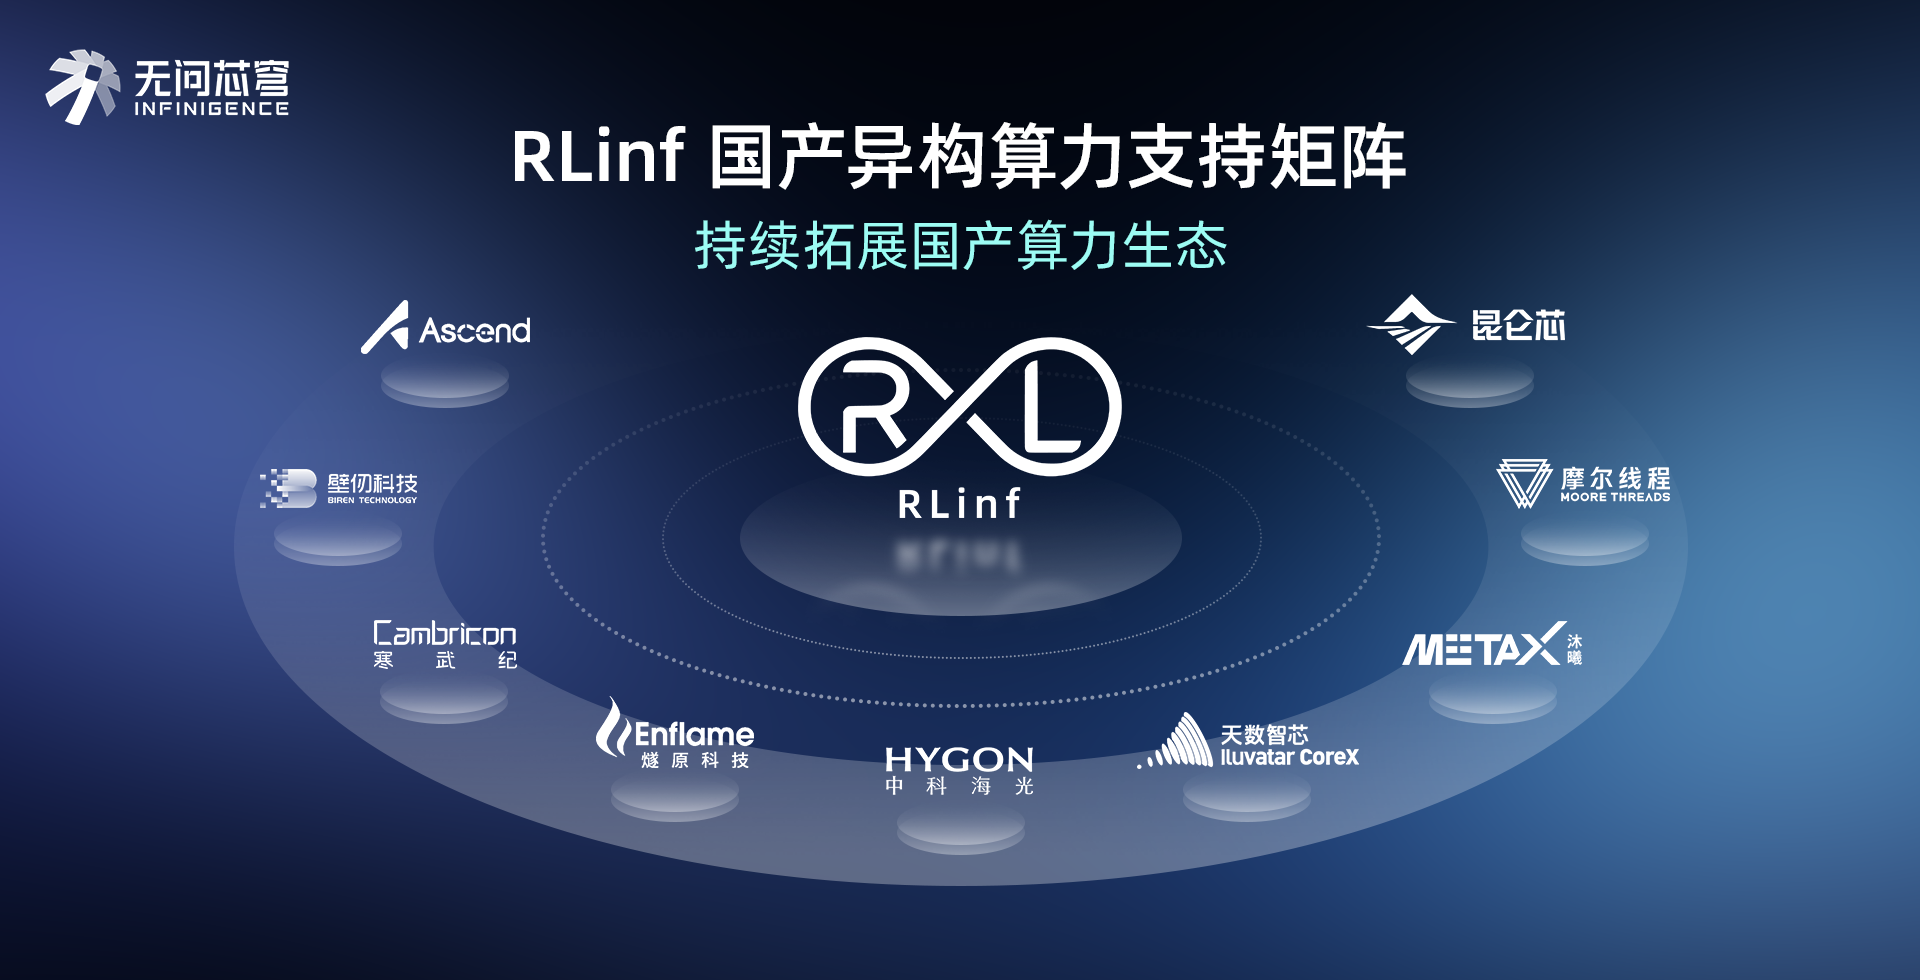
异构算力、开源生态与前沿研究拓展:新增昆仑芯、壁仞、沐曦、Intel XPU 支持,在华为昇腾与摩尔线程上实现最高 2.78× 吞吐跃升与 A100 级收敛对齐;同时,RLinf 正式入选 PyTorch 官方生态,成为 NVIDIA Isaac Lab v3.0 官方集成的强化学习训练引擎,并携手 SGLang、AMD 等伙伴发布多项社区最佳实践;前沿学术研究方面,RLinf 团队取得一系列创新成果,其中 WoVR 世界模型强化学习与 RL-Co 仿真-真机协同强化学习两项成果获顶会 CoRL 2026 接收。
本版本同样对已支持的各类训练与评测配方进行了严格的正确性与可复现性验证(见文末测试结果),感谢所有社区贡献者与测试者的倾力共建!
01 具身强化学习全链路能力升级
1. 打造“乐高式”模块化机器人架构
设计了硬件与任务解耦的统一模块化机器人接口,支持机械臂、末端、相机与底盘的灵活组合,新增 3 款真机平台与全套双臂/单臂采训推工具链:
统一机器人架构:
全新模块化真机接口(rlinf.robotics):将机器人硬件驱动、任务定义与环境 wrapper 解耦,支持按统一层级路径组合机械臂、灵巧手/夹爪、多视角相机与移动底盘;更换底层硬件驱动或调整跨节点部署拓扑时无需修改任务与策略代码。
真机平台与训练链路扩展:
双臂 Franka 全流程升级:新增 PICO VR 双臂遥操作采集、按臂独立接管的 双臂 HG-DAgger 在线训练,以及基于原生 PyTorch OpenPI π₀.₅ 的双臂 SFT 与真机部署支持。
单臂 Franka 能力增强:新增 Qwen-VL 真机视觉语言奖励模型、深度相机采集、平滑人工接管(Smooth Intervention)、DAgger 在线流式写入 LeRobot 数据集,以及 LeRobot 数据集分片合并与过滤工具链。
新增 3 款真机平台支持:新增 双臂 YAM(支持 PICO VR 遥操作与 LeRobot 数据集采集)、AgileX Piper(松灵) 与 SO-101 机械臂平台接入支持。
2. 突破真机训练效率与实时控制瓶颈
在真机在线强化学习、无标注离线策略优化、在线蒸馏与高频实时控制四个方向新增多项 SOTA 算法,大幅降低真机样本开销并显著提升任务成功率与部署流畅度:
真机与仿真强化学习算法:
新增 RLT(RL Token)两阶段在线强化学习:将高维视觉表征学习与在线 RL 控制解耦,第一阶段联合微调 VLA 与 RLT token 特征提取器,第二阶段基于冻结的紧凑表征训练轻量级 Off-Policy Actor-Critic(含 TD3 变体),大幅降低真机在线 RL 的样本与计算成本,在 ManiSkill 与 Franka 真机精密插孔(Peg Insertion)任务上实现高效收敛。
新增 STEAM 自监督离线优势建模算法:无需人工标注、手工奖励或在线环境交互,仅利用示教视频帧对的时序偏序训练深度集成进度评论器(worst-of-N),自动提取帧级优势并驱动无分类器引导(CFG)策略优化;在双臂叠毛巾、商品结账、可乐补货等复杂真机任务上显著超越 RECAP 基线。
在线策略蒸馏与实时控制:
新增 OPD(On-Policy Distillation)在线策略蒸馏:在 Student 自采样轨迹上由 Teacher 进行 token 级密集打分(打分后即时卸载以节省显存),在 LIBERO-Spatial 上仅需 30 步训练即可将 OpenVLA-OFT Student 成功率从 67% 提升至 96%+。
新增 RTC(Real-Time Control)异步实时控制:将下一动作 chunk 的模型推理与当前 chunk 的环境执行异步重叠,并通过软/硬掩码引导平滑动作边界,将 rollout 推理等待时间从数秒压缩至 ~2 ms(接近零等待),单回合耗时最高缩短 7.4 秒,支持 LIBERO 仿真与 Franka 真机高频流畅控制。
3. 新增五大具身模型支持
继续扩展具身模型生态,新增 5 款具身模型(涵盖世界动作模型与 VLA 模型)并完成 OpenPI 原生 PyTorch 重构,全面覆盖 SFT、在线 RL 与高吞吐闭环评测:
OpenPI(π₀ / π₀.₅)PyTorch 原生重实现:重新实现与官方 JAX 参考数值严格对齐的 PyTorch 版 π₀ / π₀.₅,彻底解决原社区 PyTorch 版本的数值精度偏差与收敛性问题,全面打通 LIBERO、ManiSkill、BEHAVIOR-1K、RoboTwin 及单/双臂 Franka 真机的全量 SFT、LoRA 与 RL 训练。
新增 NVIDIA Cosmos3 世界动作模型支持:支持 16B MoT(Mixture-of-Transformers)全模态世界动作模型在 LIBERO 上的 FSDP2 监督微调(训练收敛精度与官方对齐),并结合 SGLang 实现多 batch 与流水线并行评测,评测吞吐相比直接集成提升 3.33×。
新增 FastWAM 世界动作模型支持:支持基于视频扩散的世界动作模型 FastWAM 在 LIBERO 四大套件上的 FSDP 监督微调与批量闭环评测。
新增 π₀-FAST 模型支持:接入 LeRobot 自回归动作 token 策略 π₀-FAST,支持在 LIBERO-Long 上的确定性评测与 token-level GRPO 在线强化学习微调。
新增 Evo-1 模型支持:原生集成轻量级(约 1B,InternVL3-1B + DiT flow-matching 动作头)VLA 模型 Evo-1,支持在 LIBERO 上的全参数 SFT 与 GRPO 微调。
新增 MolmoAct2 模型支持:支持 AllenAI 开源 VLA 模型 MolmoAct2 在 LIBERO 四大套件(Spatial / Object / Goal / Long)上的并行闭环评测。
4. 加速算法向真实场景迁移
拓展大规模家居操作基准与高保真真机链路仿真,并构建面向世界动作模型与 VLA 的高吞吐评测体系:
新增 RoboCasa365 仿真基准:支持大规模家居操作环境 RoboCasa365 及 OpenPI PPO 在线强化学习训练。
新增真机链路仿真器(Real-World Simulator):支持在仿真训练中注入真实传感器观测延迟分布与跨集群/边云网络带宽及延迟限制,让真机算法在进入物理实机前即可完成高保真系统回归验证。
新增 SGLang 与 ApxInf 高速评测后端:完善具身模型 SGLang 推理服务评测路径(覆盖 Cosmos3、DreamZero 等世界动作模型);新增基于 Rust/CUDA 的 ApxInf 进程内推理后端,支持 π₀.₅ 在 LIBERO 上的低延迟评测。
现有仿真器完善:LIBERO 新增相机标定、任意分辨率渲染与跳过中间帧渲染加速,并对齐 LIBERO-Pro 初始扰动状态;RoboTwin 新增新版 DAgger 与内存回收优化;EmbodiChain 升级至 0.3.0。
5. 深化异构国产算力适配与系统优化
在分布式图像与张量传输、权重重分片及训练可观测性上全面升级;新增 4 款国产/异构加速卡支持,并在华为昇腾与摩尔线程上实现大幅性能突破:
性能与通信优化:
新增无损观测图像压缩:支持对 Env → Rollout 通道的图像观测进行无损压缩(XOR-delta + LZ4/Zstd),在逐比特还原的前提下将图像网络传输负载降至原始大小的 36%–41%,大幅缓解多机与边云训练的视觉带宽瓶颈。
分布式通信与权重同步加速:新增集合通信张量压缩(Tensor Compression)、灵活轨迹传输(Flexible Trajectory Transfer)以及重构后的权重重分片(Weight Reshard)机制,并支持异步 Runner 下 Rollout 与权重同步的安全重叠。
训练栈与可观测性升级:默认运行时升级至 PyTorch 2.11(配套新版 SGLang / vLLM),支持 FSDP 模块级混合精度策略、SGLang VLM 趋势奖励服务(QwenTrend)以及全链路分布式 Tracing / Profiling。
国产卡与跨硬件生态:
新增 4 款异构加速卡支持:新增 昆仑芯(Kunlunxin XPU)、壁仞(Biren SUPA)、沐曦(MetaX MACA)国产卡 与 Intel XPU 硬件后端支持;至此 RLinf 已实现同一套训练栈无缝运行于 NVIDIA、AMD 及 6 大主流国产/异构加速卡。
华为昇腾(Ascend CANN)模型扩展与深度性能优化:新增 GR00T(N1.5 / N1.6 / N1.7)、StarVLA、DreamZero、Wan 世界模型在昇腾 NPU 上的训练支持;通过 Attention 控制元数据缓存、NPU 融合算子路由、设备端批量预处理与 FSDP 前后向预取重叠,使 GR00T N1.5/N1.6 动作推理吞吐提升 195%–278%、四卡训练吞吐提升 37%–42%,StarVLA 训练调用吞吐提升 186%–240%,10 款主流具身模型在 Ascend 910B3 上达到 A100 75%+ 的端到端计算效率。
摩尔线程(MUSA)端到端测试与世界模型 RL 复现:完善 MUSA 安装脚本、Docker 镜像与端到端测试;在 S5000 上完成 WoVR 世界模型强化学习完整闭环复现,191 步训练成功率曲线与 A100 相关系数达 0.976(LIBERO 评测成功率 74.6% vs A100 73.4%),双机混合分片优化使整步耗时降低 15.3%、权重同步耗时降低 66%。
02 首次打通图像与视频生成模型强化学习
首次将强化学习训练能力从具身策略拓展至独立的图像与视频扩散生成模型流水线:
集成 Diffusion-NFT 视觉生成强化学习:将扩散模型的生成过程抽象为强化学习环境,支持对 SD3 图像生成模型与 Wan2.2(含 TI2V-5B) 视频生成模型进行在线 RL 微调,内置图像级 OCR 与视频帧级 Video OCR 奖励打分器,并支持扩展自定义媒体评分模型。03 扩展大模型与多智能体训练能力
扩展大规模 MoE 模型推理训练与多智能体 FSDP 训练后端:
新增 Moonlight-16B-A3B(DeepSeek-V3 架构)GRPO 训练:基于 Megatron-Bridge(TP=8、EP=8)与 SGLang 专家并行,支持采用多头潜在注意力(MLA)与 MoE 架构的 Moonlight-16B-A3B 及 DeepSeek-V3 / Kimi-K2 架构模型进行数学推理强化学习。
新增多智能体 FSDP 后端(MA-FSDP):使多智能体协同强化学习同时支持 FSDP 与 Megatron 两大训练后端,降低多智能体实验的硬件与配置门槛;同时新增 SearchR1 的 FSDP 训练配置。
03 持续进行开源生态合作拓展与前沿学术研究
本版本在国际主流开源生态、工业界平台集成与顶会学术研究上取得多项重要进展:
入选 PyTorch 官方生态(PyTorch Ecosystem):RLinf 正式成为 PyTorch 生态成员,持续向全球 PyTorch 社区输出可扩展的具身与智能体强化学习能力。
NVIDIA Isaac Lab v3.0.0 官方集成:Isaac Lab v3.0.0 正式采用 RLinf 作为其 VLA 后训练与强化学习训练基础设施。
RLinf × SGLang 深度合作:打通 Cosmos3、DreamZero 等世界动作模型的 SFT 与 SGLang 流水线并行评测全流程,实现 3.33× 评测吞吐提升。RLinf x SGLang :Cosmos3 从模型微调到高效评测的全流程集成实践分享
RLinf × AMD 深度合作:在 AMD MI300(ROCm)上复现 WoVR 静态世界模型强化学习,并引入冻结 Qwen3-VL(TOPReward)零训练奖励替代任务专用奖励模型,将 LIBERO-Spatial 成功率从 44.8% 提升至 56.0%,在无需奖励模型训练的前提下达到专用 ResNet 奖励模型同等水平。基于 RLinf 与 AMD GPU 实践世界模型强化学习
NSDI 2027 论文接收:RLinf 团队提出的 MoE 高性能变换-通信融合库 FUSCO: High-Performance Distributed Data Shuffling via Transformation-Communication Fusion 被网络与系统顶会 NSDI 2027 接收。论文:arXiv:2512.22036
CoRL 2026 论文接收:RLinf 团队提出的 VLA 仿真-真机强化学习协同训练框架 RL-Co,论文 Beyond Imitation: Reinforcement Learning-Based Sim-Real Co-Training for VLA Models 被机器人学习顶会 CoRL 2026 接收。论文:arXiv:2602.12628
CoRL 2026 论文接收:RLinf 团队提出的基于世界模型的 VLA 强化学习后训练框架 WoVR,论文 WoVR: World Models as Reliable Simulators for Post-Training VLA Policies with RL 被机器人学习顶会 CoRL 2026 接收。文档:论文:arXiv:2602.13977
STEAM 论文发布:发布面向真机离线强化学习的自监督时序集成优势建模论文 STEAM: Self-Supervised Temporal Ensemble Advantage Modeling for Real-World Robot Learning。 论文:arXiv:2606.29834
04 版本更新与开发指南
1. 强化数值正确性与分布式训练稳定性
v0.4 修复了若干影响训练数值精度、分布式通信稳定性与断点续训的问题,建议大家升级到最新版以获取这些修复。主要包括:
算法与数值正确性:修复 PPO Actor 指标未按有效 mask 宽度归一化、熵正则项随 micro-batch 误缩放、ReinForce++ 基线在单样本组下崩溃、DAgger bootstrap mask 不对齐、Co-training 中未应用 SFT loss,以及 Critic 解释方差(Explained Variance)未全局聚合的问题。
模型与训练后端:修复 IQL Critic 未经由 FSDP 根节点执行、FSDP 梯度范数未跨全部分片归约、FSDP2 局部 shard 恢复类型错误,以及 DCP Checkpoint 未保存单 rank 随机数状态(RNG)的问题。
分布式调度与权重同步:修复异步训练中 Rollout 与权重同步并发重叠的竞态条件、分桶权重同步(BucketWeightSyncer)参数名未排序导致的集合通信挂起、发送端初始同步缺少同步屏障,以及 FSDP 集合通信未遵循
RLINF_TIMEOUT超时配置的问题。断点续训与环境稳定性:增强 Auto-resume 对未写完 Checkpoint 的自动检测与跳过能力;修复 ManiSkill 环境卸载时的显存回收安全问题、MetaWorld 与多卡调度下的 EGL 设备映射错误,以及 LIBERO-10 GRPO 按初始状态分组采样的问题。
2. 核心训练栈与真机接口迁移指南
从 v0.3 升级到 v0.4 请注意以下变化:
运行环境重建:v0.4 默认升级至 PyTorch 2.11 与新版 SGLang / vLLM,请使用
requirements/install.sh重新构建虚拟环境或拉取rlinf0.4系列 Docker 镜像,不要直接复用 v0.3 的虚拟环境。真机接口迁移:原
rlinf.envs.realworld与rlinf.scheduler.hardware.robots已统一迁移至rlinf.robotics与rlinf.envs.real,自定义真机接入请参考RLinf 使用文档中接入新机器人。OpenPI 权重与配置:
model_type: openpi现已默认指向与 JAX 对齐的新版 PyTorch 实现;若需加载旧版 OpenPI-PyTorch 训练的 Checkpoint,请先使用 Checkpoint 转换工具进行转换。
3. 持续完善结果正确性与可复现性
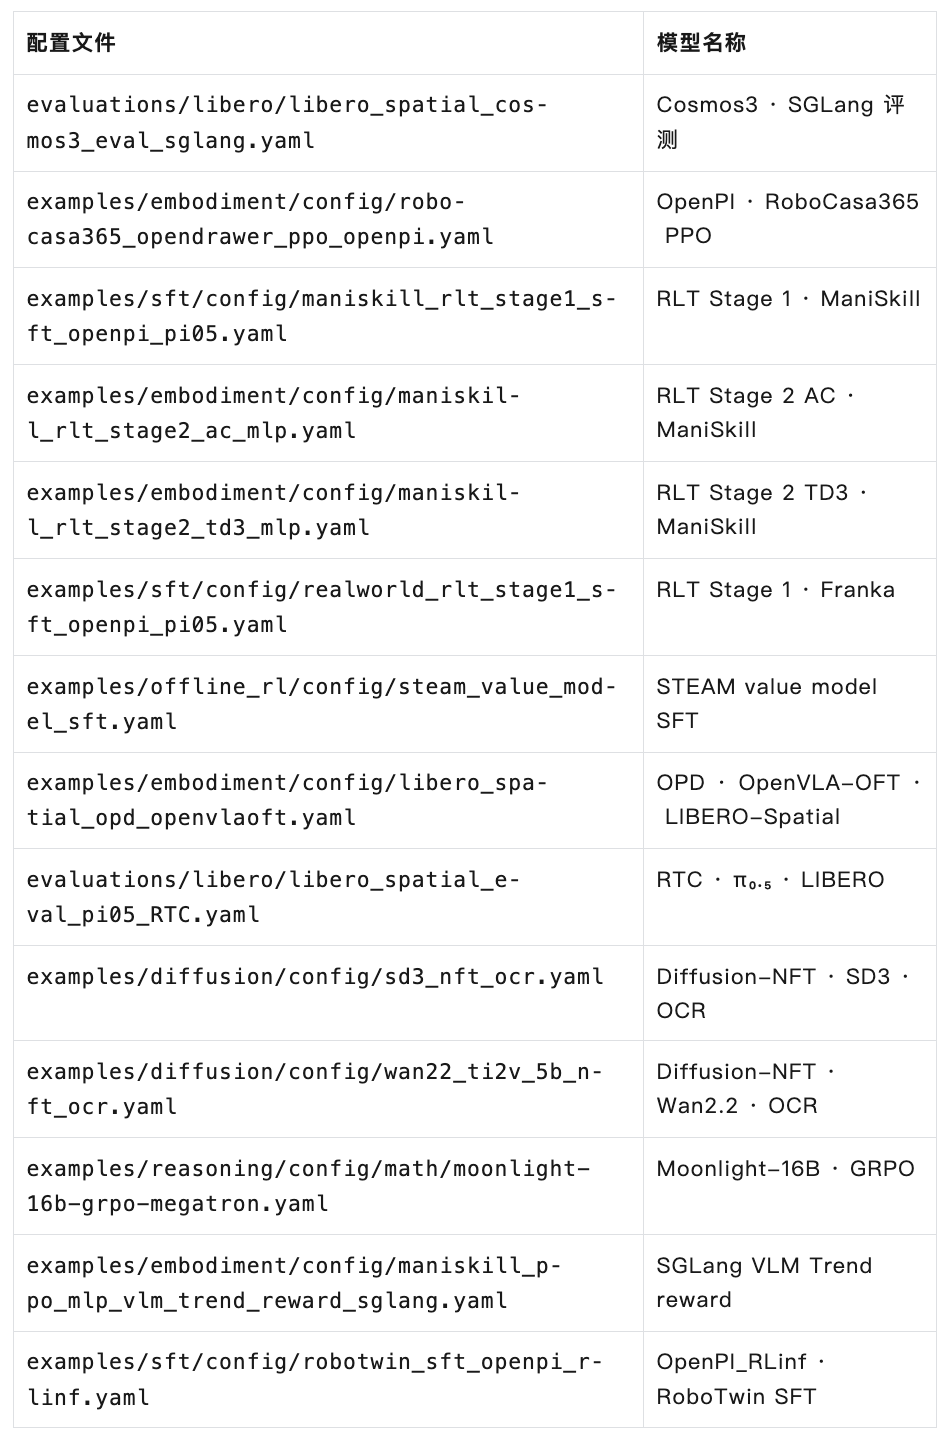
相对 v0.3,下列配置是本版本新增或重点升级的代表性示例。正确性曲线将在正式打 tag 前按 v0.3 同标准补齐;当前请以仓库 examples/ 与 evaluations/ 中的配方为准做回归。结果曲线请见 RLinf 文档中 v0.4 发布说明。
4. 安装部署与使用指南
安装指南:<https://rlinf.readthedocs.io/zh-cn/latest/rst_source/start/installation.html>
无问芯穹:<https://docs.neogpu.com/posts/rlinf-ppo-vla.html>
RLinf 使用文档:<https://rlinf.readthedocs.io/zh-cn/latest/index.html>