10 月 22 日,在 Qcon 全球软件开发大会上,上海交通大学人工智能学院副教授、无问芯穹联合创始人兼首席科学家戴国浩发表了题为《以 Agentic Infra 技术实践支撑词元工厂持续演进》的演讲。他结合团队近几个月的技术实践与思考,探讨了智能体时代 Token 供需关系的变化,并提出:面对指数级增长的需求,仅靠扩大算力规模、提高 Token 生产效率,并不足以持续弥合供需缺口,需要将 AI 引入基础设施自身的优化与演进过程,为 Token 供给引入“增长加速度”。
戴国浩指出,当前智能体正推动全球 Token 需求集中释放,并呈现长期持续的指数级增长趋势,而与之相对的是供给端势能不足。持续扩大的缺口倒逼软硬件架构革新,向上支撑模型、应用,向下整合芯片、能源的 AI 基础设施撬动供给量与速的乘数效应。
01 增“量”:以规模与效率并行抬升供应曲线的斜率
在戴国浩看来,在供给的“增量”上有两个重要锚点:一是整合物理供给,扩大可用、可优化的算力资源规模;二是提升有效供给,提高电能向 Token 的转化效率。前者做大资源底盘,后者提高单位资源的有效产出,两者协同才能持续抬升供给曲线的斜率。
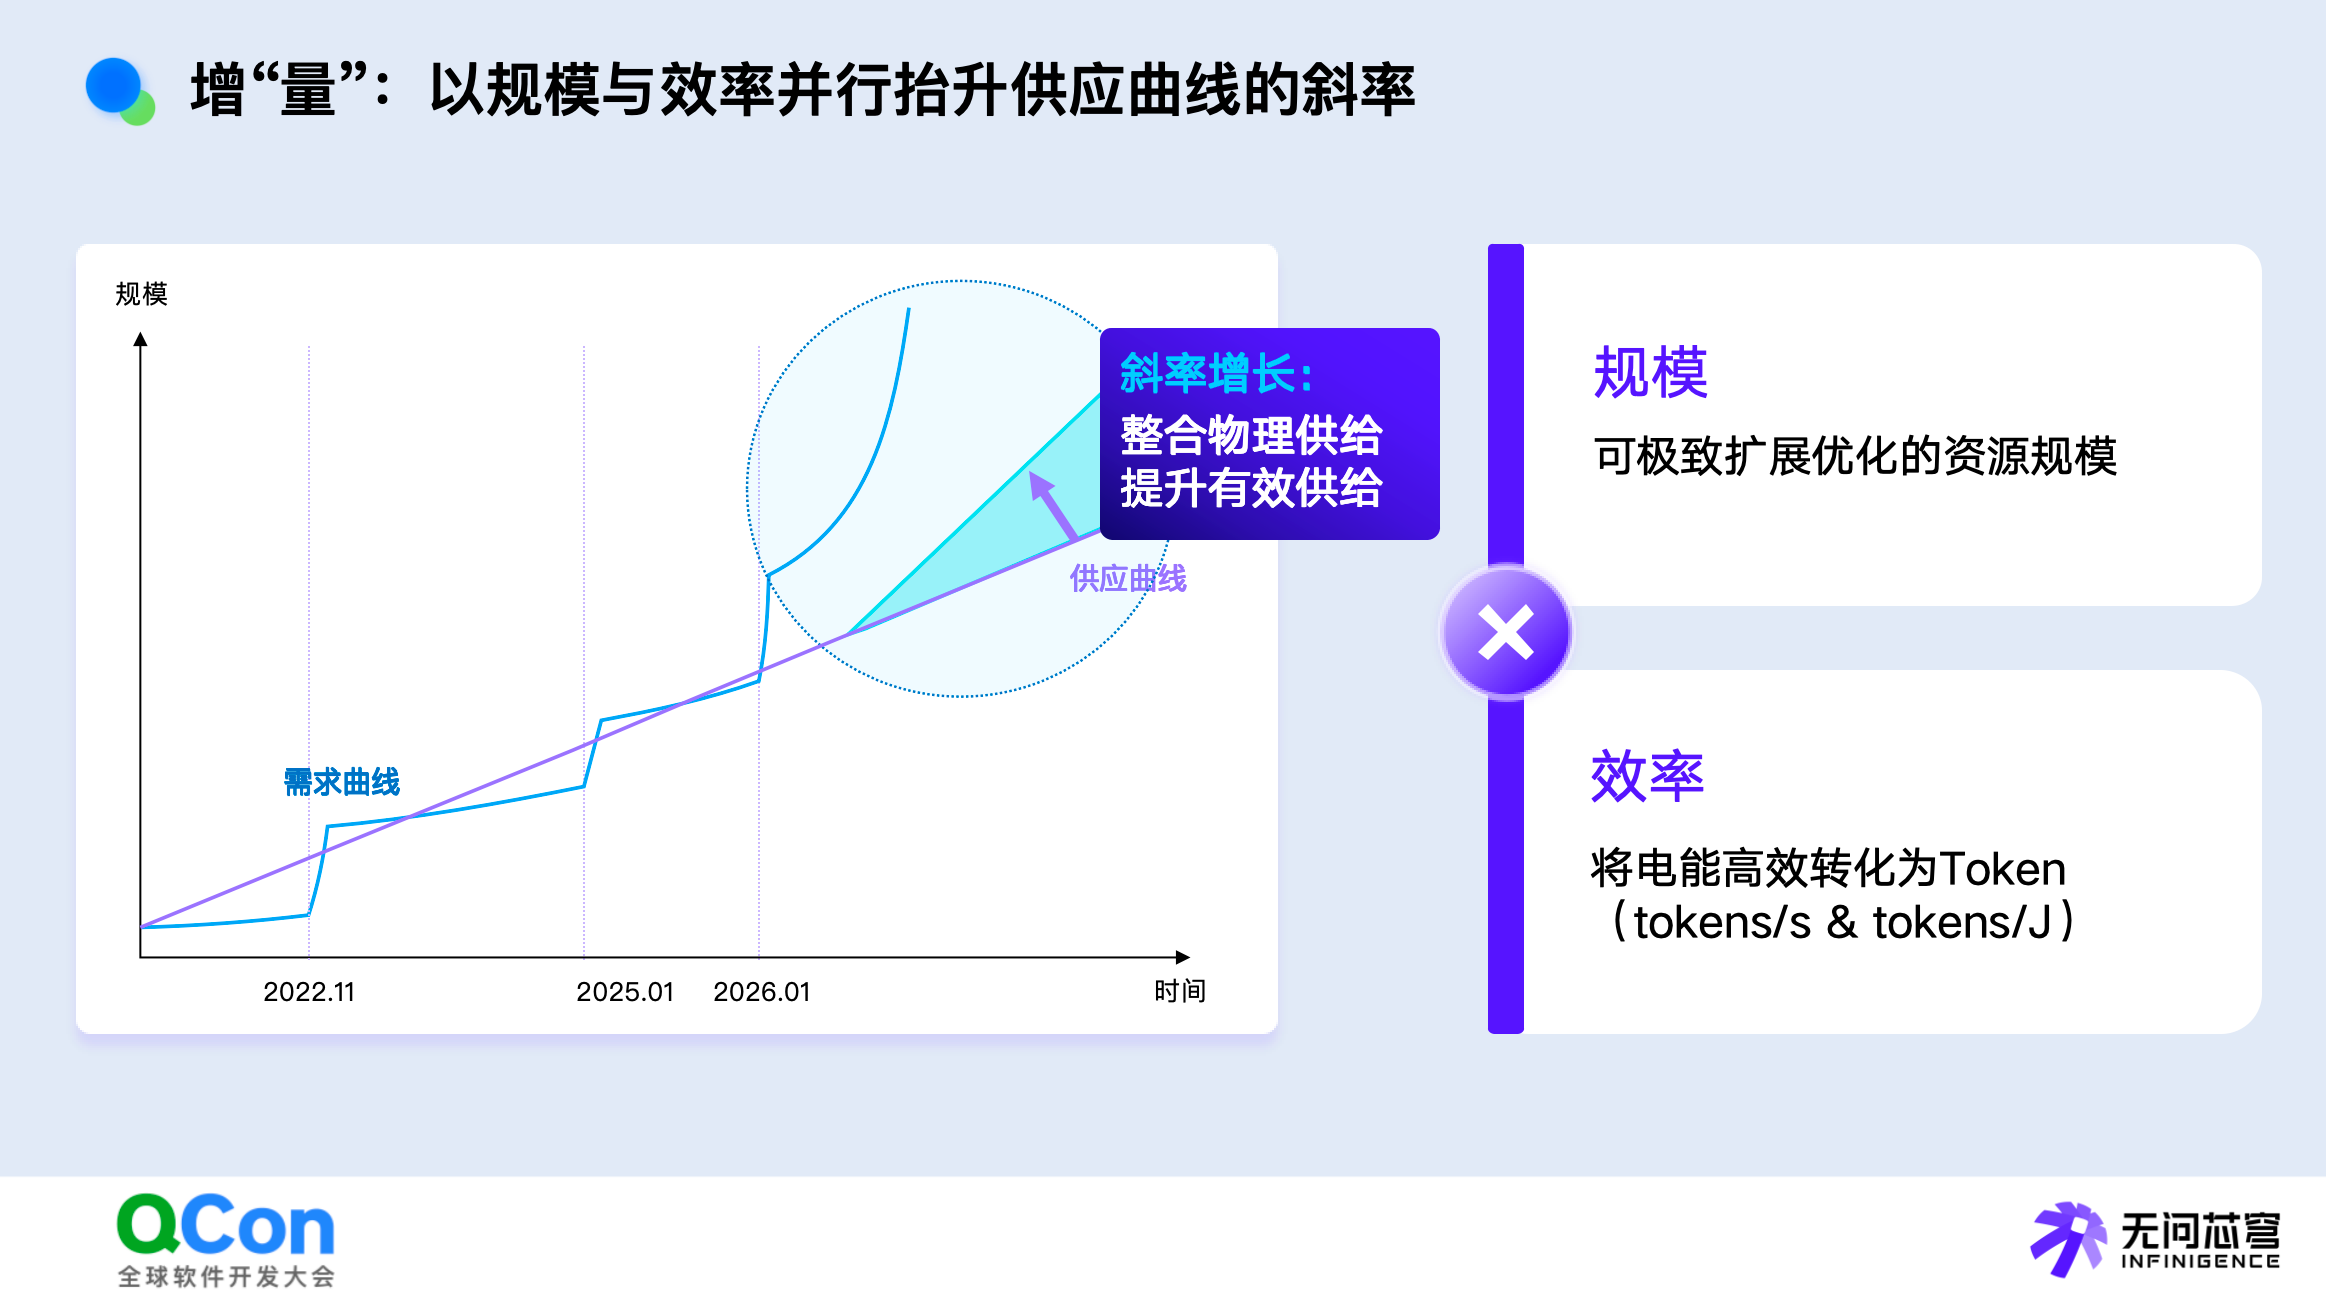
跨域异质算力集合做大资源底盘,实现智能资源规模最大化
在整合物理供给上,无问芯穹目前已围绕多元异构统一资源抽象、多元异构统一算力调度、分布式训练容错恢复和全链路可观测智能运维治理等技术,构建了跨域异质算力协同能力。目前已支持 16 种芯片品牌,触达 37,000 P 算力资源;实现 4+2 六种芯片的异构千卡混合训练,异构集群训练效率最高达到 97.6%;2天内完成新推出芯片适配,国产芯片适配成本降低 70% 以上。
针对跨集群推理中的计算与通信瓶颈,无问芯穹也进一步提出 PDD 三级分离式推理架构(Prefill–Relay Decode–Main Decode)。在 Prefill 与主 Decode 集群之间引入 Relay Decode 中继环节,通过计算与 KV Cache 传输重叠,减少跨集群数据传输带来的等待开销,实现跨集群异构混合推理,让分散各处的存量资源充分释放产业价值。
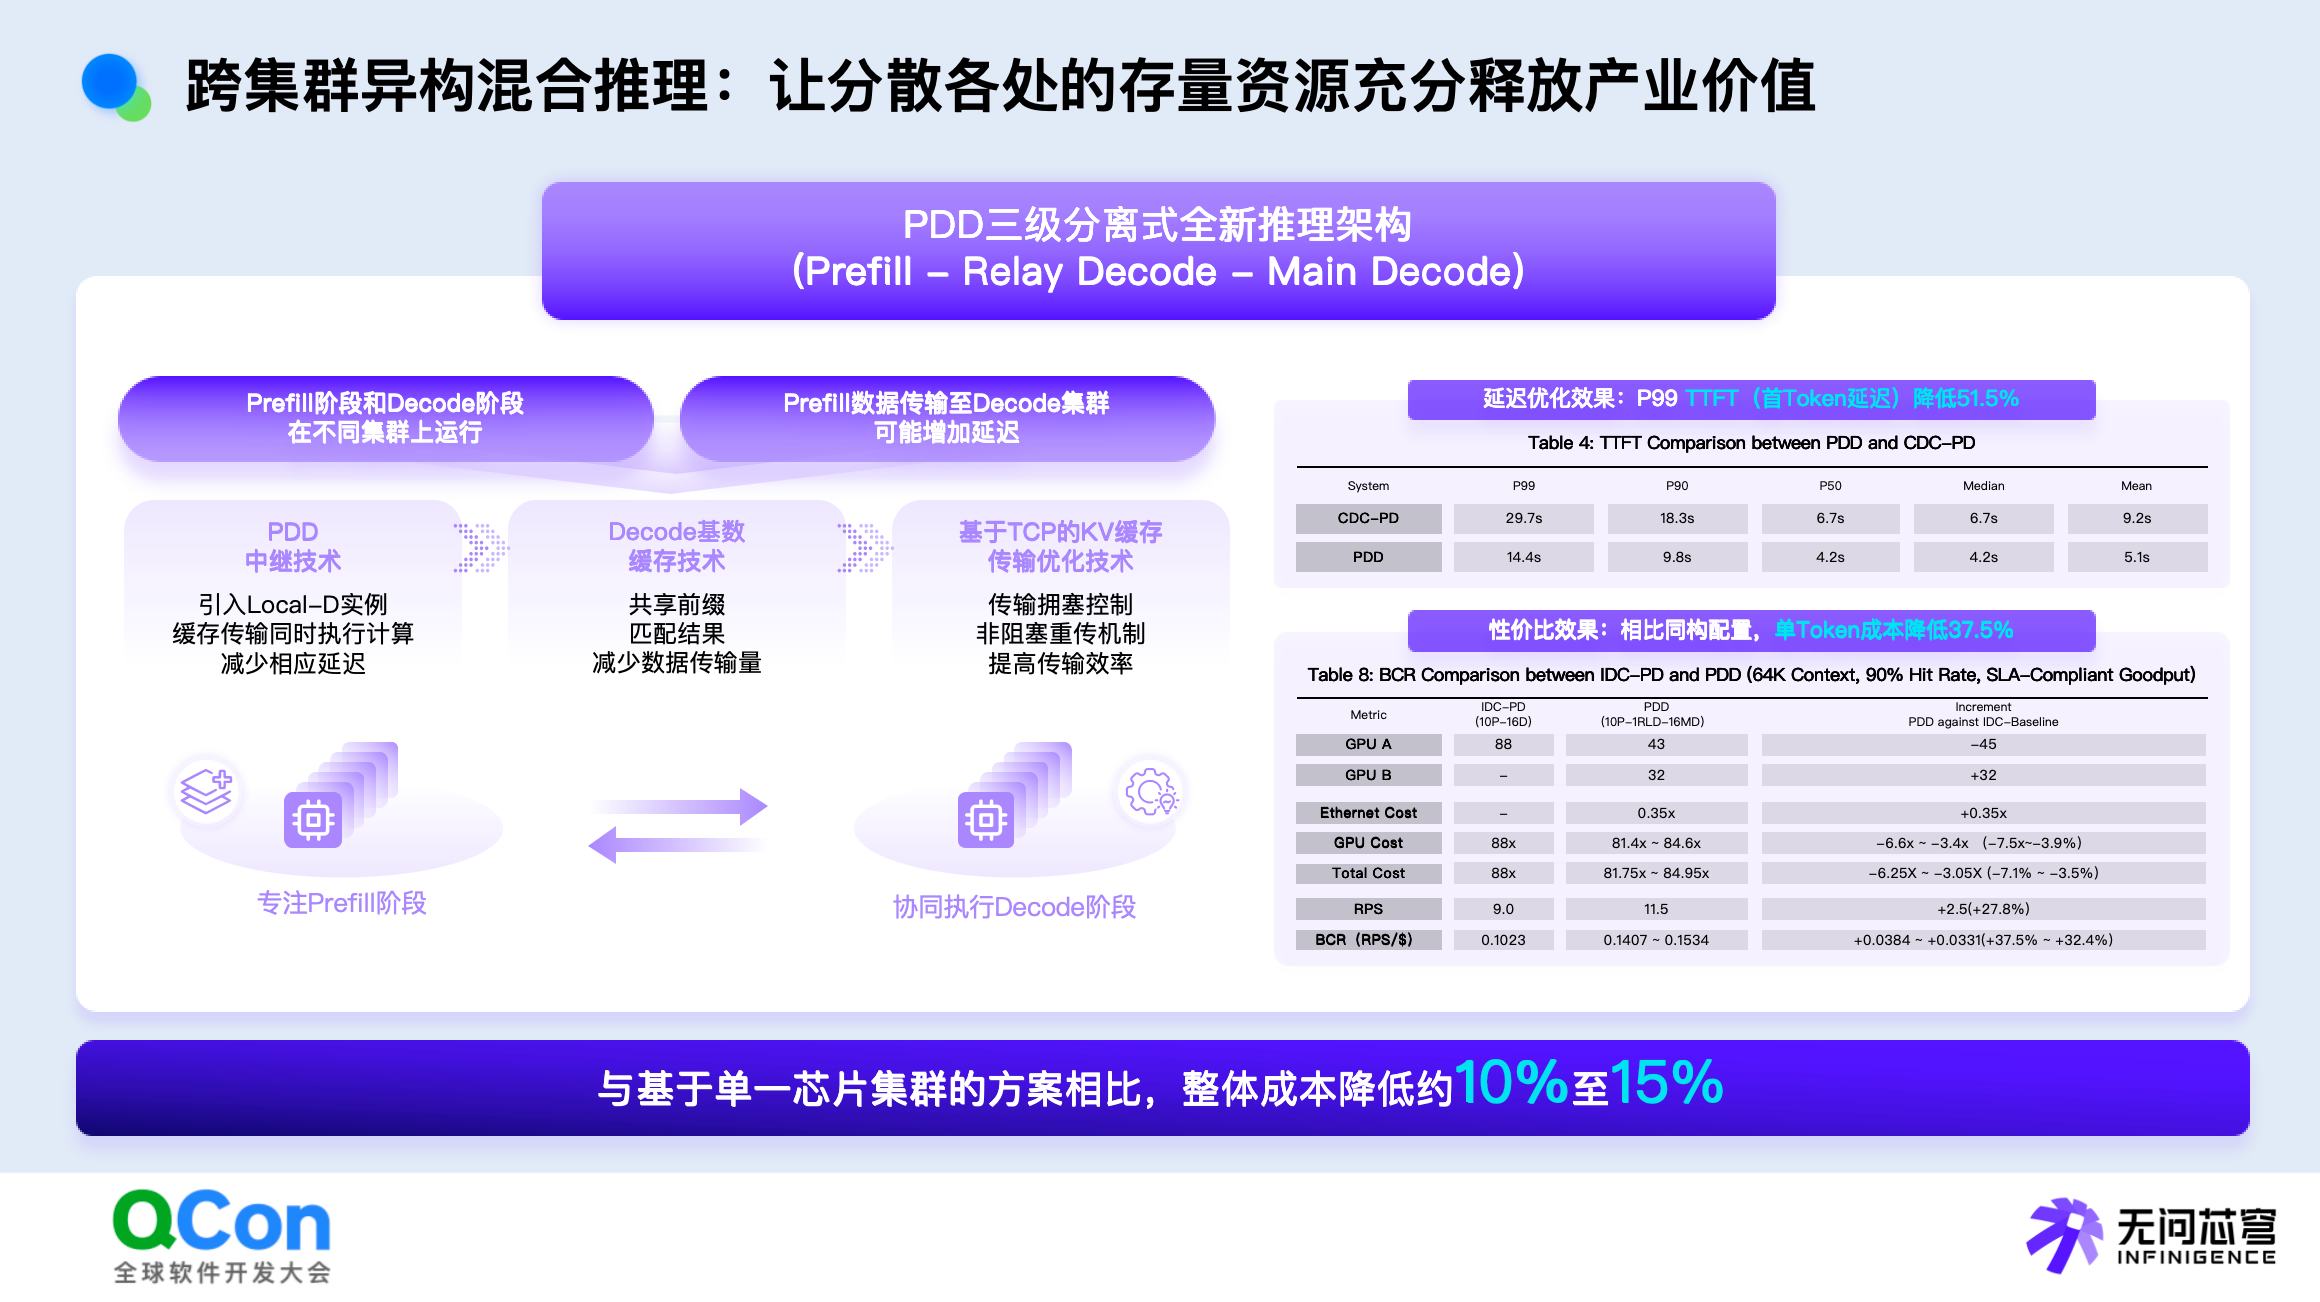
这些实践指向的是将原本难以直接协同的异构算力组织成更大规模、稳定可用的资源池。对于 Token 供给而言,这意味着有效资源的边界不再完全取决于单个集群的物理规模,而能够通过跨芯片、跨集群、跨地域协同进一步扩展。
软硬协同系统级效率优化,提供更有效的Token供给
在做大资源底盘的同时,无问芯穹持续推进推理系统的软硬协同优化,通过协同模型运行、调度系统与硬件集群,提高算力向高效、稳定、低成本 Token 供给的转化效率。相关技术路线覆盖实例推理、计算与通信重叠、PD 分离与半分离、MTP 与 Cache 优化,以及 FlashDecoding++、FlashOverlap、Semi-PD 等工作,从不同层次释放推理系统的效率空间,过去一年已实现推理成本下降 10 倍。
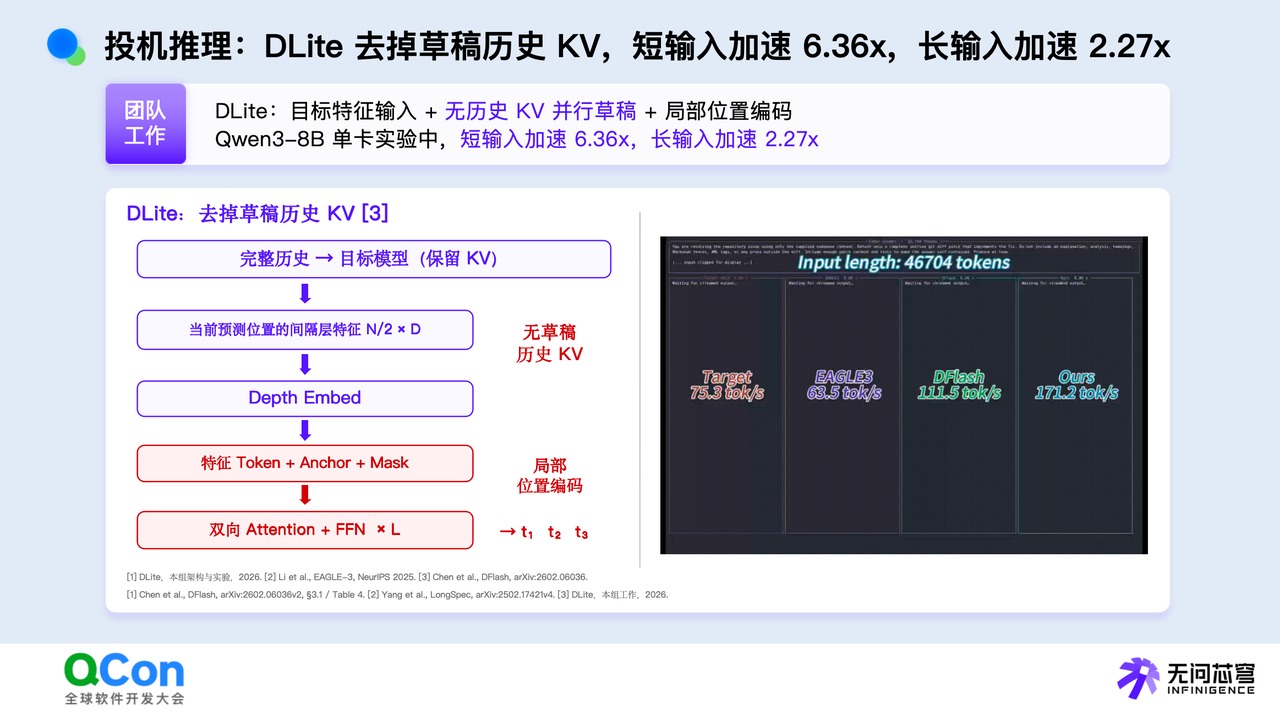
针对 Agent 场景下上下文不断增长带来的投机推理效率问题,戴国浩也介绍了无问芯穹最新的 DLite 投机推理方案,通过去掉草稿侧的历史 KV Cache,同时保留目标模型的完整 KV Cache,并结合间隔层特征、局部位置编码和并行草稿生成,缩短草稿生成路径。在 Qwen3-8B 单卡实验中,DLite 在短输入场景下实现 6.36 倍加速,在长输入场景下实现 2.27 倍加速。
从跨域异构算力整合到推理系统优化,这些工作共同指向一个目标:在扩大资源规模的同时,让既有资源产生更多、更便宜的 Token。但更高的增长斜率只能实现线性追赶,仍难匹配指数级的需求增长。据此戴国浩进一步指出:仍需要进一步为Token供给引入“增长加速度”。
02 提“速”:以反馈驱动的自主改进推动供给与指数需求同阶
在探索“提速”的具体路径之前,戴国浩首先提出了一个重要的视角转换。
过去,信息系统围绕比特与 CMOS 构建,工程师需要探索怎样组合 CMOS、微架构和系统组件,以获得更高的计算性能;而在大模型与智能体成为新的技术基础后,系统的组织方式进一步延伸至 LLM、工具、Agent、Harness 和 Workflow 的组合。AI 可以参与模型调用、工具组织、工作流生成乃至基础设施自身的优化。因此,Agent 时代的供给核心,正从 Token 生产效率进一步延伸至 Token 向任务成果的转化效率,“单位可验证任务成本”已成为衡量有效供给的关键指标。
无论是 AI4Math 中通过多智能体协作与形式化验证提升科学推理产出,还是 AI4Infra 中利用 AI 优化基础设施运维与计算性能,都指向同一个趋势:AI 基础设施面临的机会不再只有“如何更高效地生产 Token”,还包括“如何利用 AI 提升整个生产系统的效率”。
基于这一判断,戴国浩提出供给 2.0 的核心进路:以反馈驱动的自主改进,为 Token 供给引入“增长加速度”,推动供给曲线与指数需求同阶。
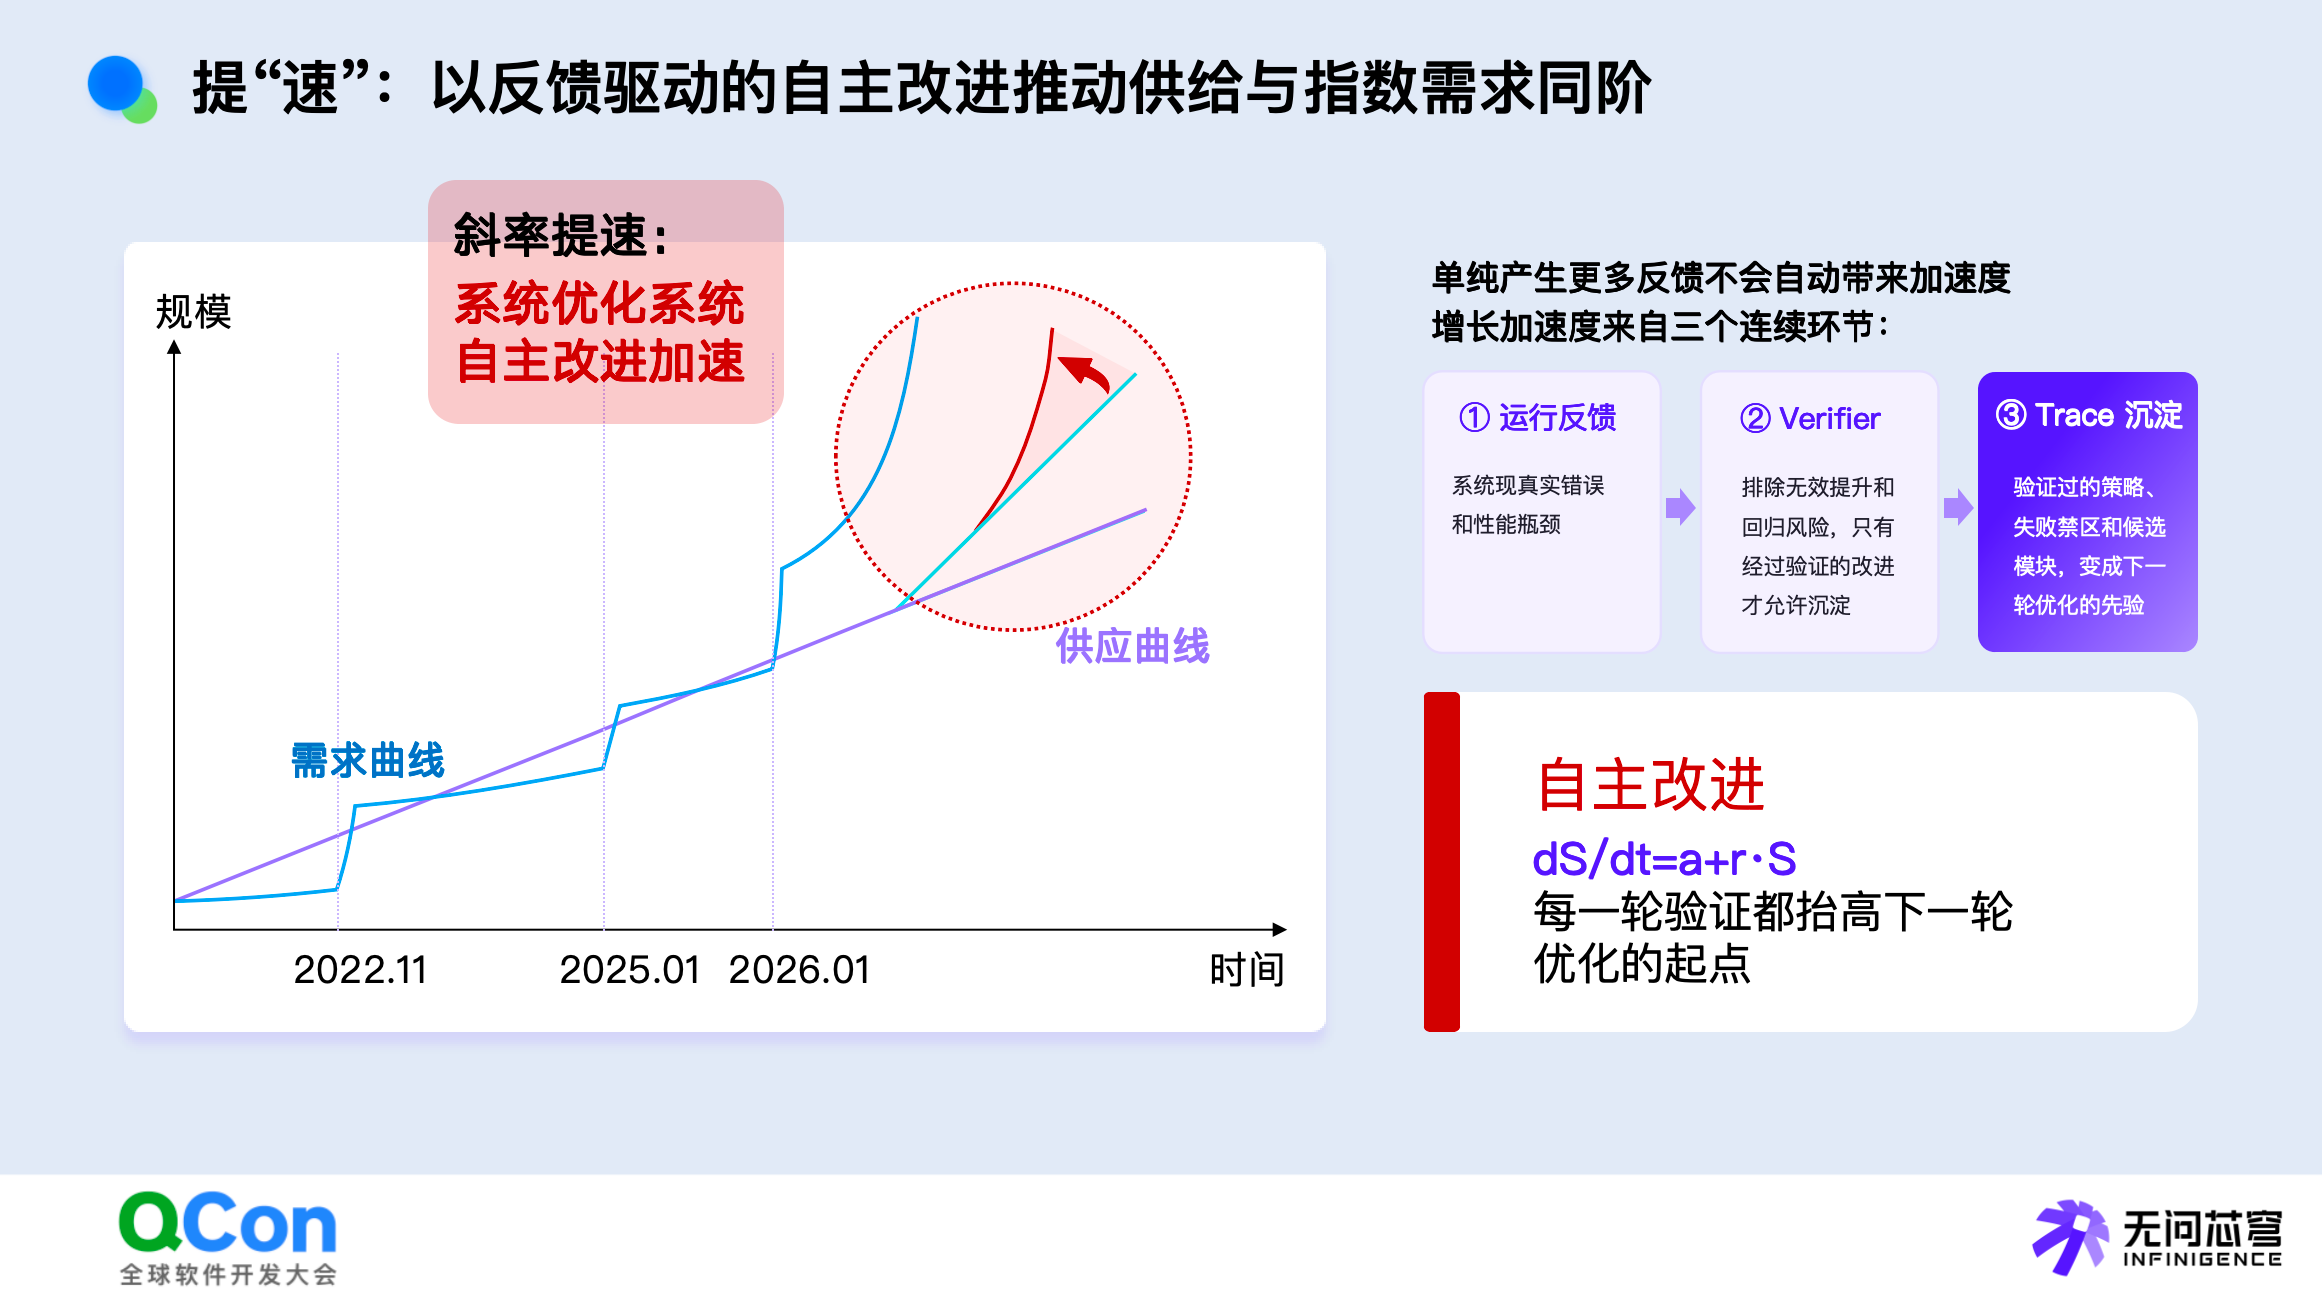
戴国浩强调,反馈本身不会自动带来增长加速度。关键在于,每一轮经过验证的改进,都应成为下一轮优化的起点,而不是让系统反复从相同状态重新开始。
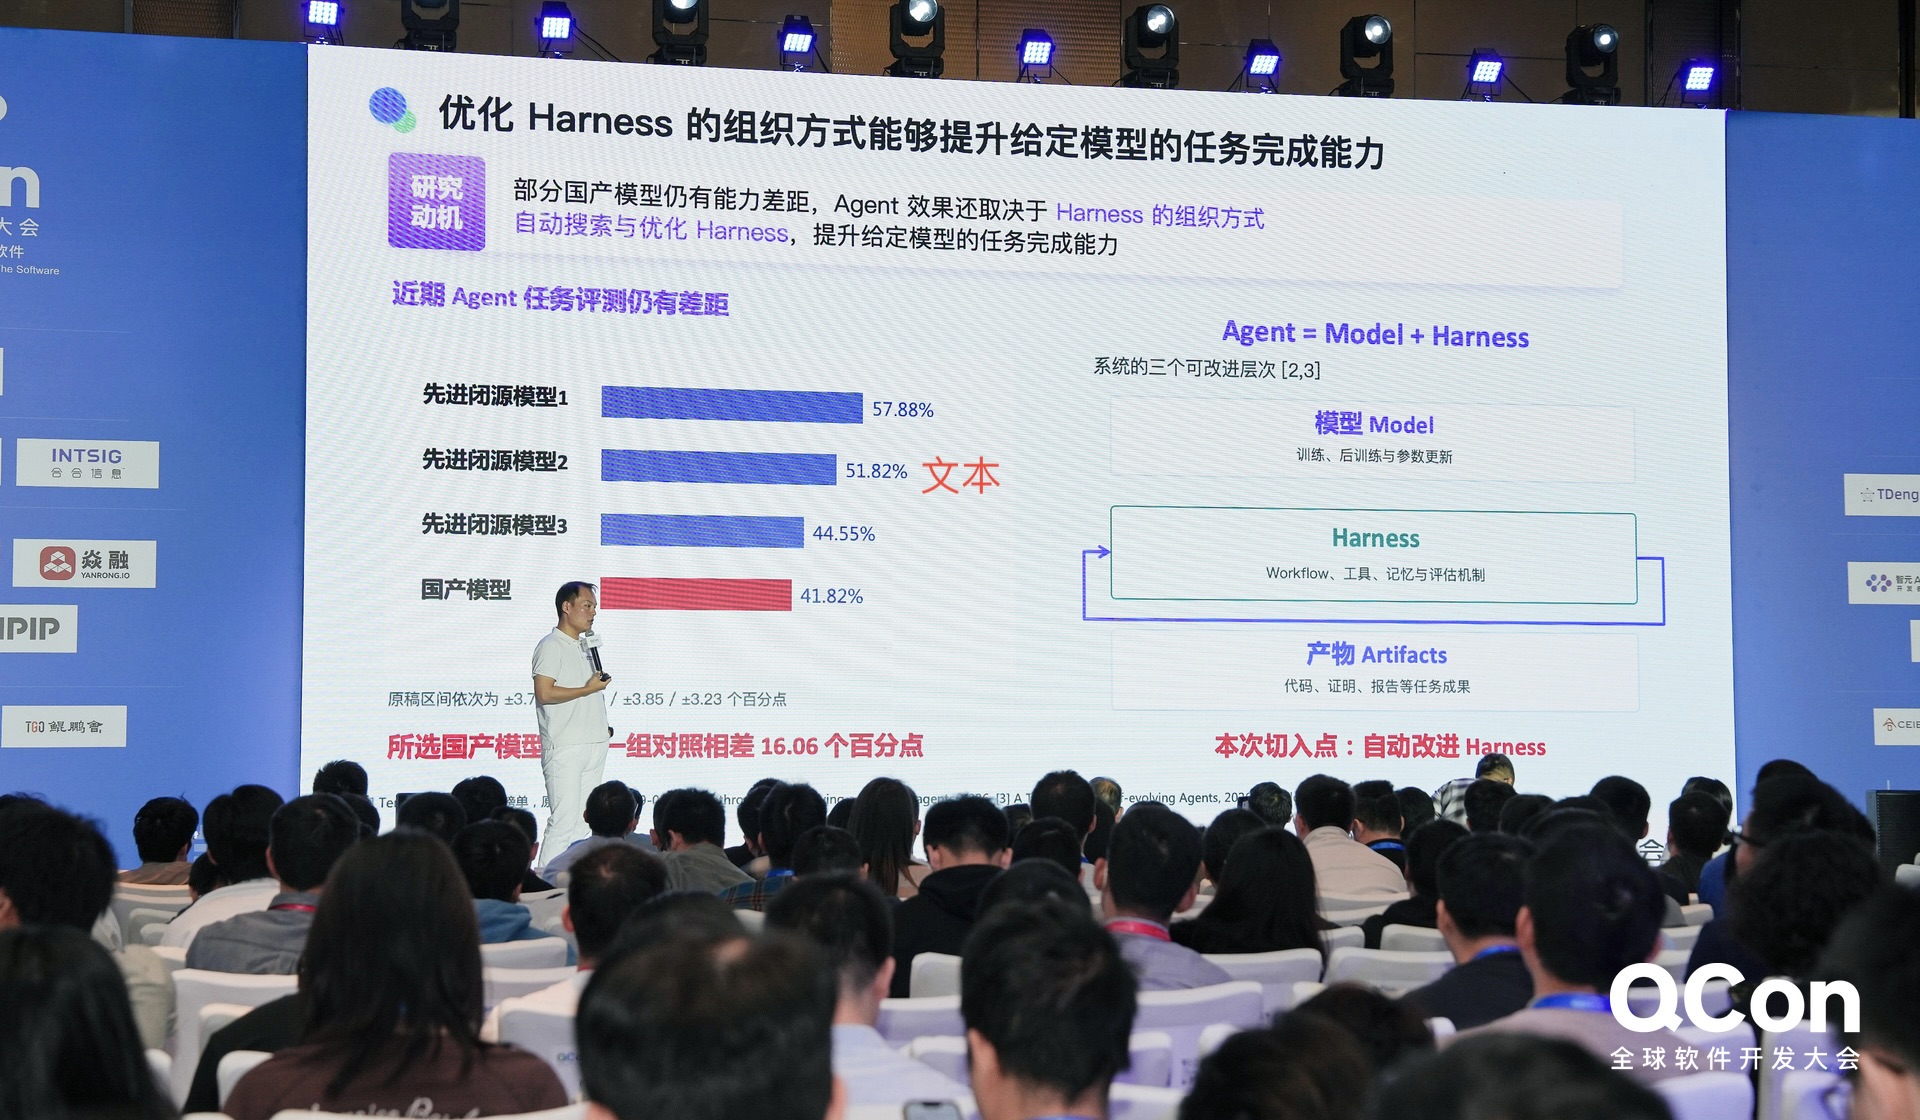
“Agent 应用中,模型能力固然重要,但模型并不是决定最终任务效果的唯一因素。Agent 效果还取决于 Harness 的组织方式。”一系列已有工作已证明,智能系统的改进对象,正从生成轨迹扩展到 Workflow 与 Agent 自身。他指出:“无问芯穹相信能够建立一套 Token maxxing 的 Agent Harness,在满足质量约束的前提下最小化端到端成本,通过优化轨迹数据进一步改进 Agent 系统的优化策略,逐步向 RSI 推进。”
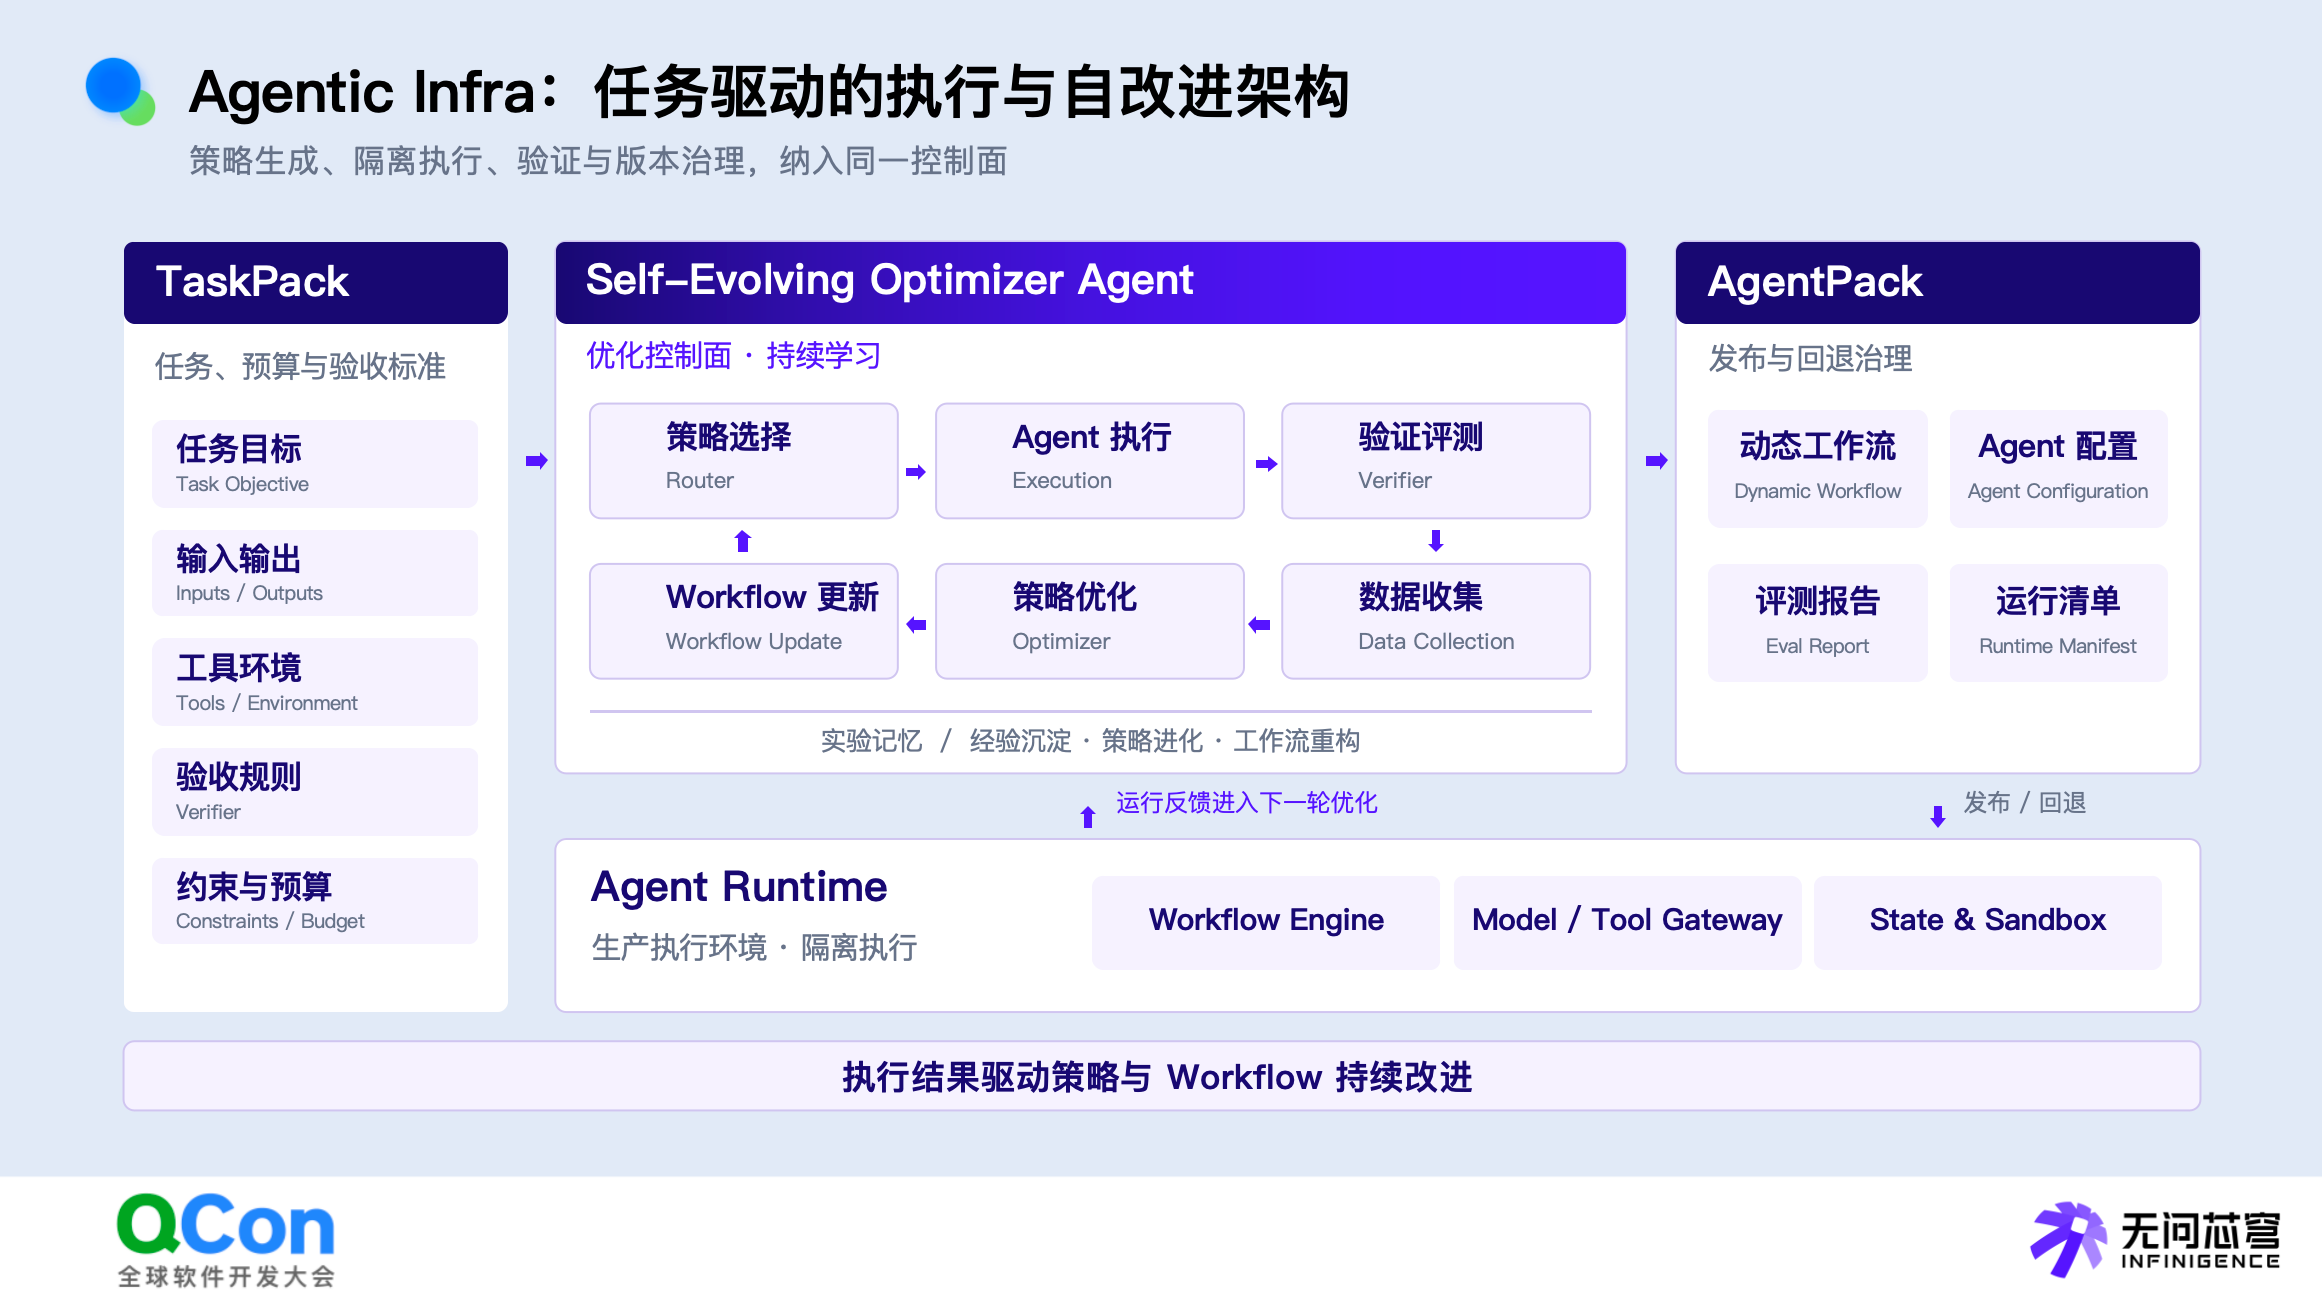
Dynamic Workflow:让开源模型获得新的能力增长曲线
戴国浩提到:“达尔文告诉我们,生物通过遗传和自然选择实现进化,虽然我们目前还没有构建出如此复杂的系统,但是 30 年前机器学习领域就已经应用了遗传算法的核心思想。”因此,无问芯穹团队将遗传算法引入候选 Workflow 的搜索,通过选择、交叉与变异搜索候选 Workflow,通过执行代码生成、编译、测试及性能分析,以真实硬件上的编译结果、计算正确性和实测性能筛选候选方案并迭代。除了横向的工作流拓扑搜索,对于单个执行Agent来说,可以通过多级 Lowering,例如:从 Triton、CuTe、TileLang 等较高层表达逐步下探到 CUDA、PTX,在搜索效率与底层硬件控制能力之间取得平衡。
团队沿着这一技术方向并参考 Humanize 框架的实践经验,形成了一套算子生成 Agent,实现使用国产模型组合在多类算子上超过先进闭源模型的优化效果。
在 DSA Attention 内部实验中,36 小时内,国产模型组合的加速比达到 29.77 倍,累计输出 16.30M Token;两组先进闭源模型对照分别达到 31.26 倍和 15.20 倍。团队还在多类算子上实现了 2.40—4.35 倍的加速比。
为了让局部优化真正转化为整体收益,团队进一步将优化范围从单个算子扩展至 Attention、跨 rank 通信与 MoE 执行组成的整层,相较于SGLang,实现HighSpeed模式端到端加速最高1.86x。在多并发情况下也达到了最高1.31x的加速,进一步降低了token生产成本。
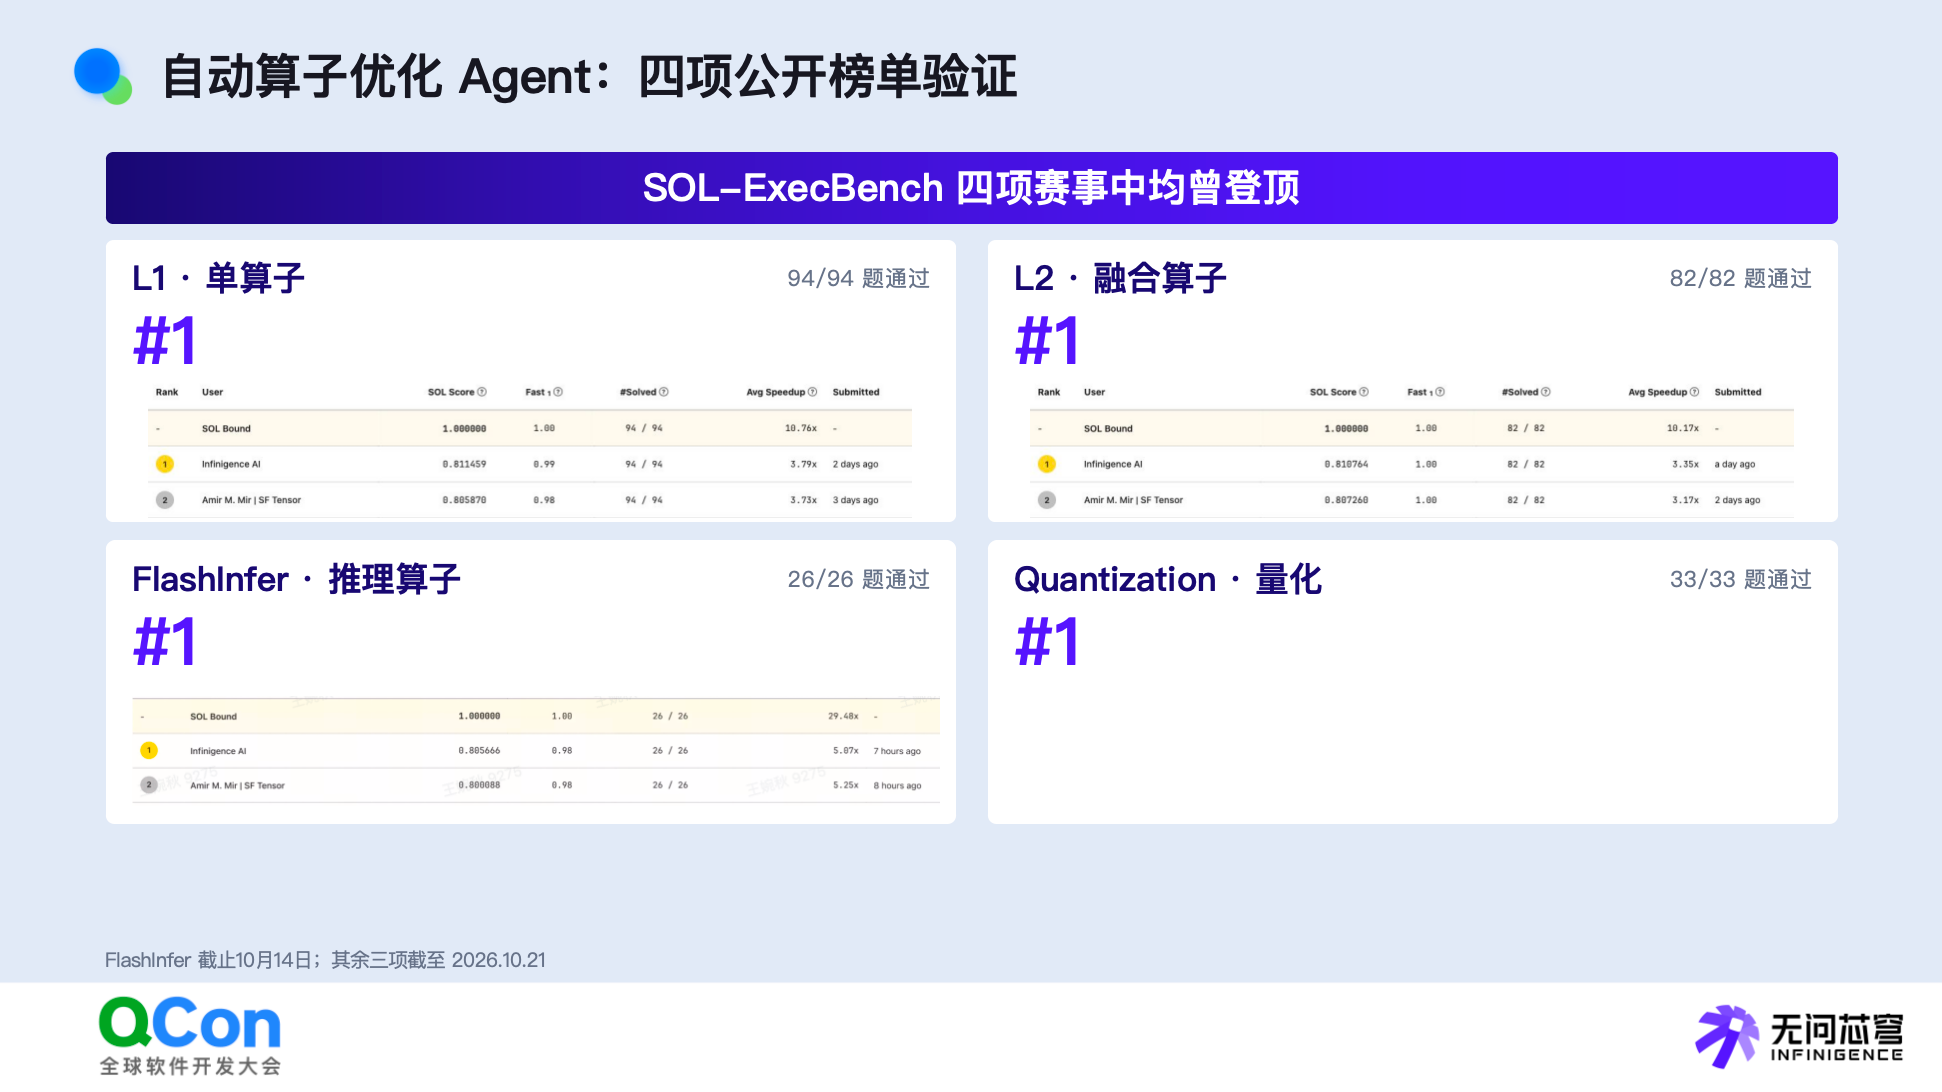
这些实践将 Kernel 优化从高度依赖人工经验的过程,转化为能够自动生成候选方案、依据真实执行结果验证,并持续保留有效改进的迭代流程。在2026 年 3 月英伟达发布的SOL-ExecBench GPU kernel 优化评测榜单中,无问芯穹在一个月内得到了L1单算子、L2融合算子、L4 FlashInfer-Bench三个赛道的第一名,L3量化赛道的第二名。验证了这套优化框架在多类任务上的竞争力。
通过 Workflow 组织多智能体协作提升科学推理产出效率
在科学推理场景中,无问芯穹进一步探索以自适应工作流组织多智能体协作,提升模型在复杂数学任务中的求解效率,将任务分配、证明生成、形式化验证与知识复用纳入统一的执行框架,形成由验证反馈驱动的迭代求解机制。
在 PutnamBench 实验中,团队将 672 道形式化数学题划分为多个任务子集,由不同智能体并行开展证明搜索。每个智能体根据 Lean 形式化验证器的反馈,持续修正证明策略与候选证明;同时,通过智能体间的共享知识库,积累可复用的证明经验,为后续轮次的证明生成提供参考,使得单个任务中的探索结果能够支持其他任务的求解,形成任务内迭代与跨任务知识复用相结合的协作机制。
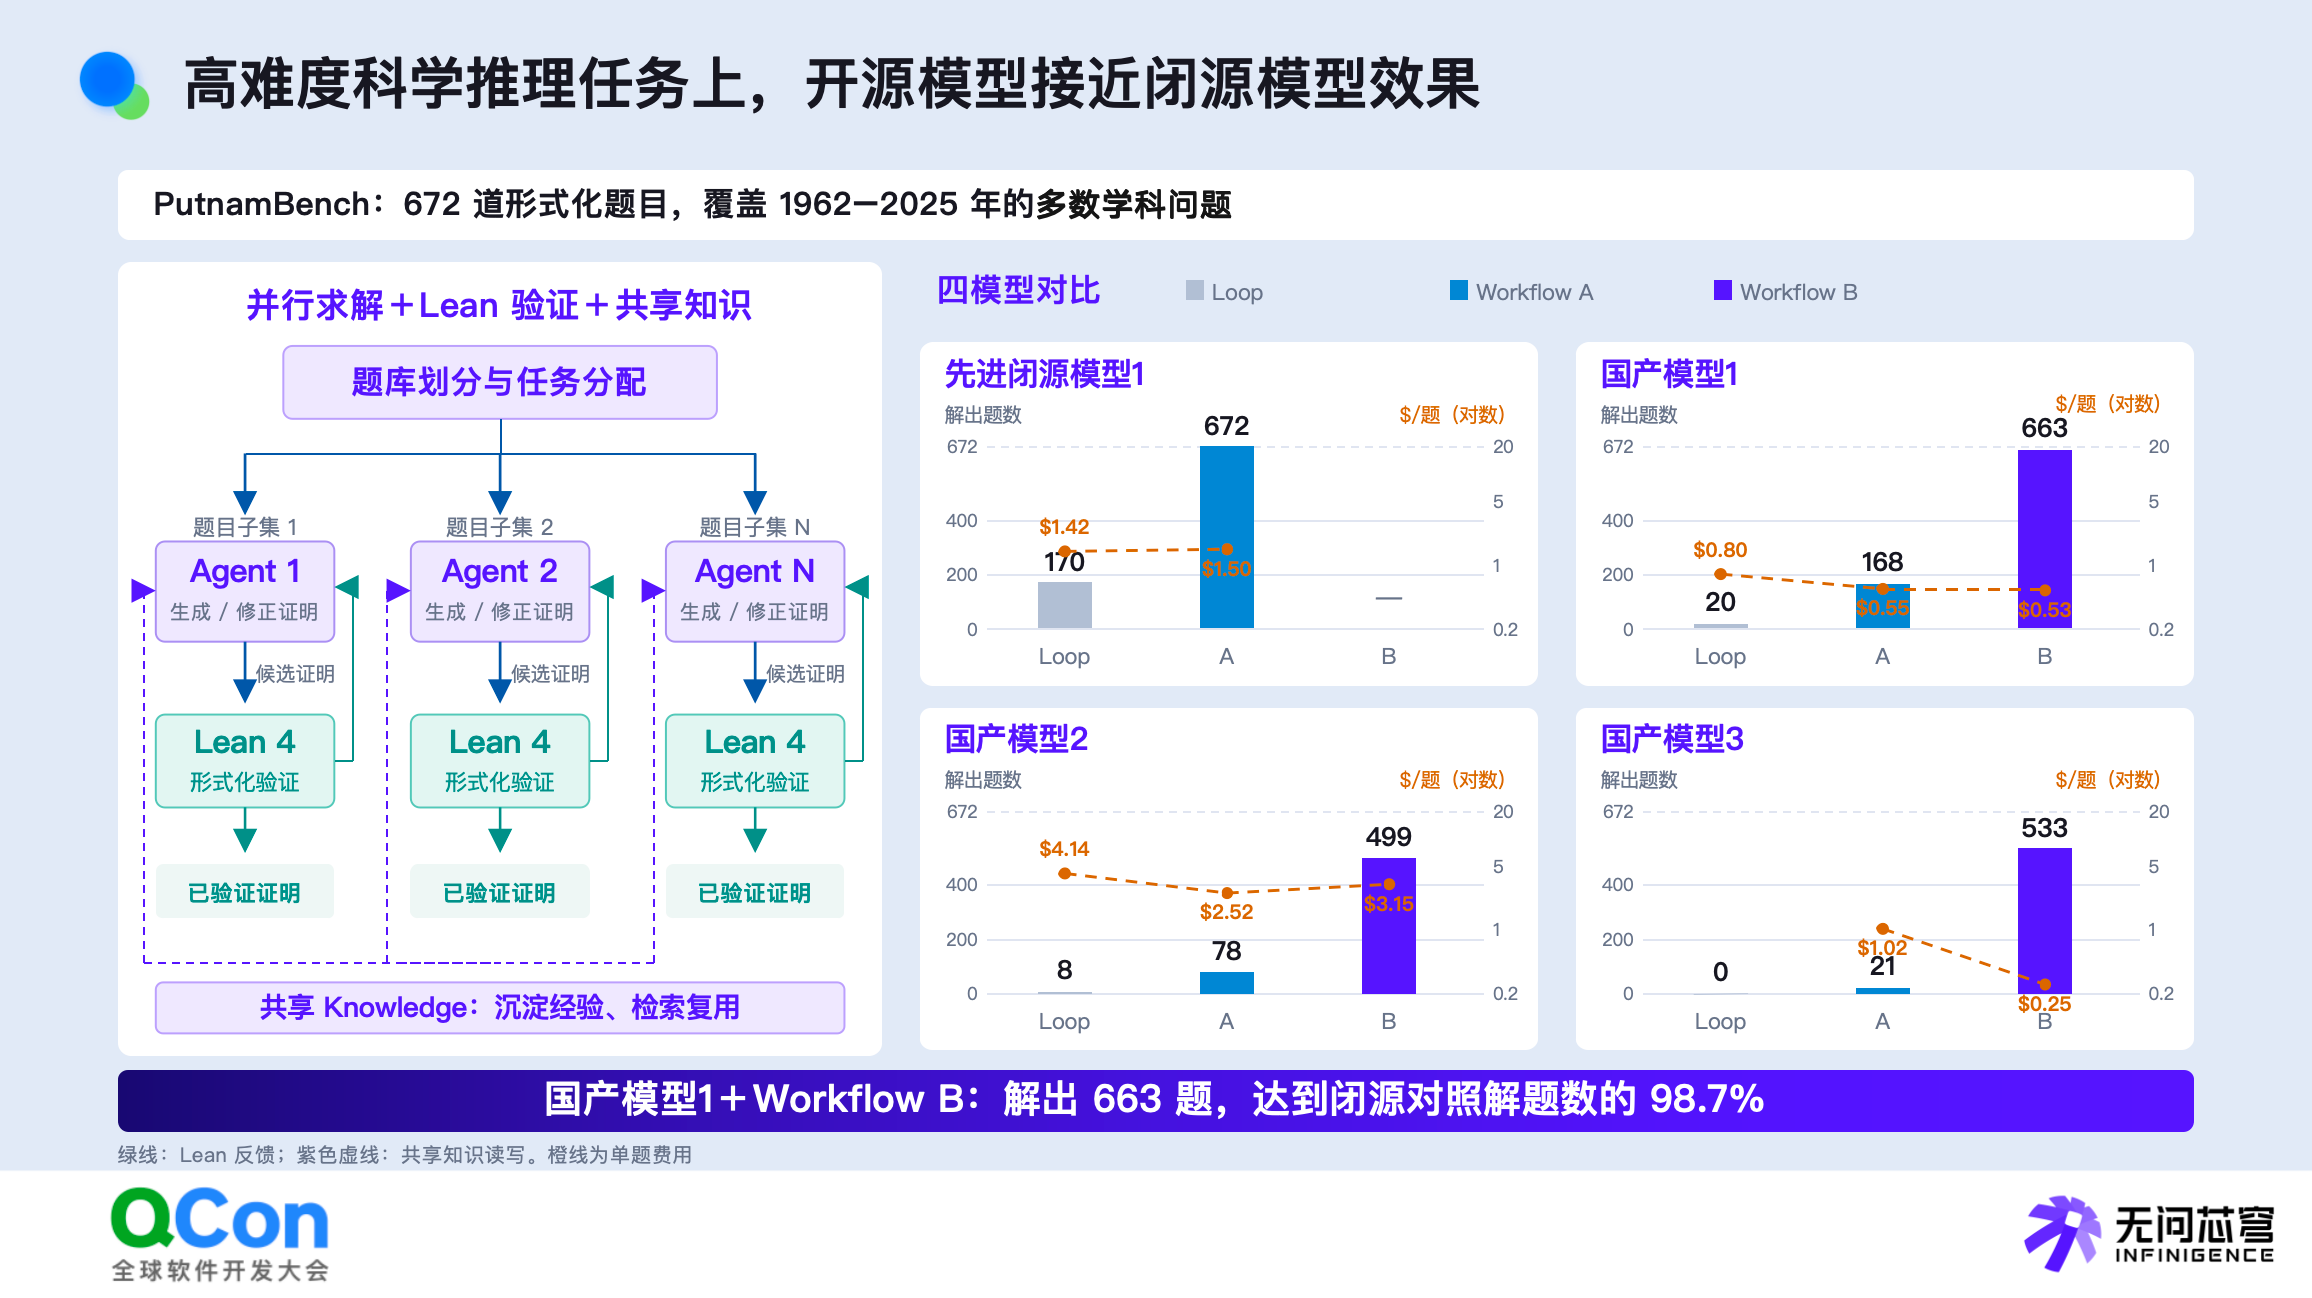
在 20 小时的时间预算内,该框架基于某国产模型成功求解 663 道题,达到先进闭源模型对照组解题数量的 98.7%(663/672);每道成功求解题目的平均费用为 0.53 美元,较闭源模型对照组的 1.50 美元降低约 64.7%。这一结果表明,科学推理场景的任务表现不仅取决于模型能力,还与任务组织、验证反馈及知识复用机制密切相关。通过模型与工作流协同设计,模型调用可以被组织为具有明确验证标准、能够积累经验并持续迭代的求解过程,从而提高 Token 向可验证任务成果的转化效率。
APXInf:将系统级优化延伸至具身智能端侧部署
在具身智能领域,无问芯穹近期开源的 APXInf 同样将软硬件协同与 Agentic Engineering 的思路引入端侧推理引擎。APXInf 通过 Python 接口降低模型接入门槛,以 Rust 系统运行时负责调度、并发和资源生命周期管理,并通过专用算子库优化端侧执行性能。团队还探索利用 Agent 自动搜索和优化算子实现,降低研发对人工逐项调优的依赖。

在 Jetson AGX Thor 上运行 PI 0.5 的实验中,团队将端到端推理时延从 278 毫秒降至 26 毫秒以内,加速超过 10.6 倍,推理频率达到 38.46 Hz。在 LIBERO-10、500 个 episode 的测试中,Thor FP8 的任务成功率为 92.2%,与 92.4% 的参考结果基本持平。
通过将高效推理能力带到机器人本体,APXInf 为具身模型的实时运行提供了端侧推理支撑,也体现出 Agent 参与系统优化的另一种实践路径。
03 面向 AGI 构建能够持续交付有效 AI 生产力的新型供给体系
演讲的最后,戴国浩再次回归到最初的供需曲线,重新审视 Agent 时代 AI 基础设施的供给目标。传统供给视角下,能否以更快速度、更低成本和更大规模提供 Token是关注的核心。但进入 Agent 时代,Token 是任务执行的投入,而非最终交付物。真正需要衡量的,是这些 Token 能否转化为可验证、可验收的任务成果。
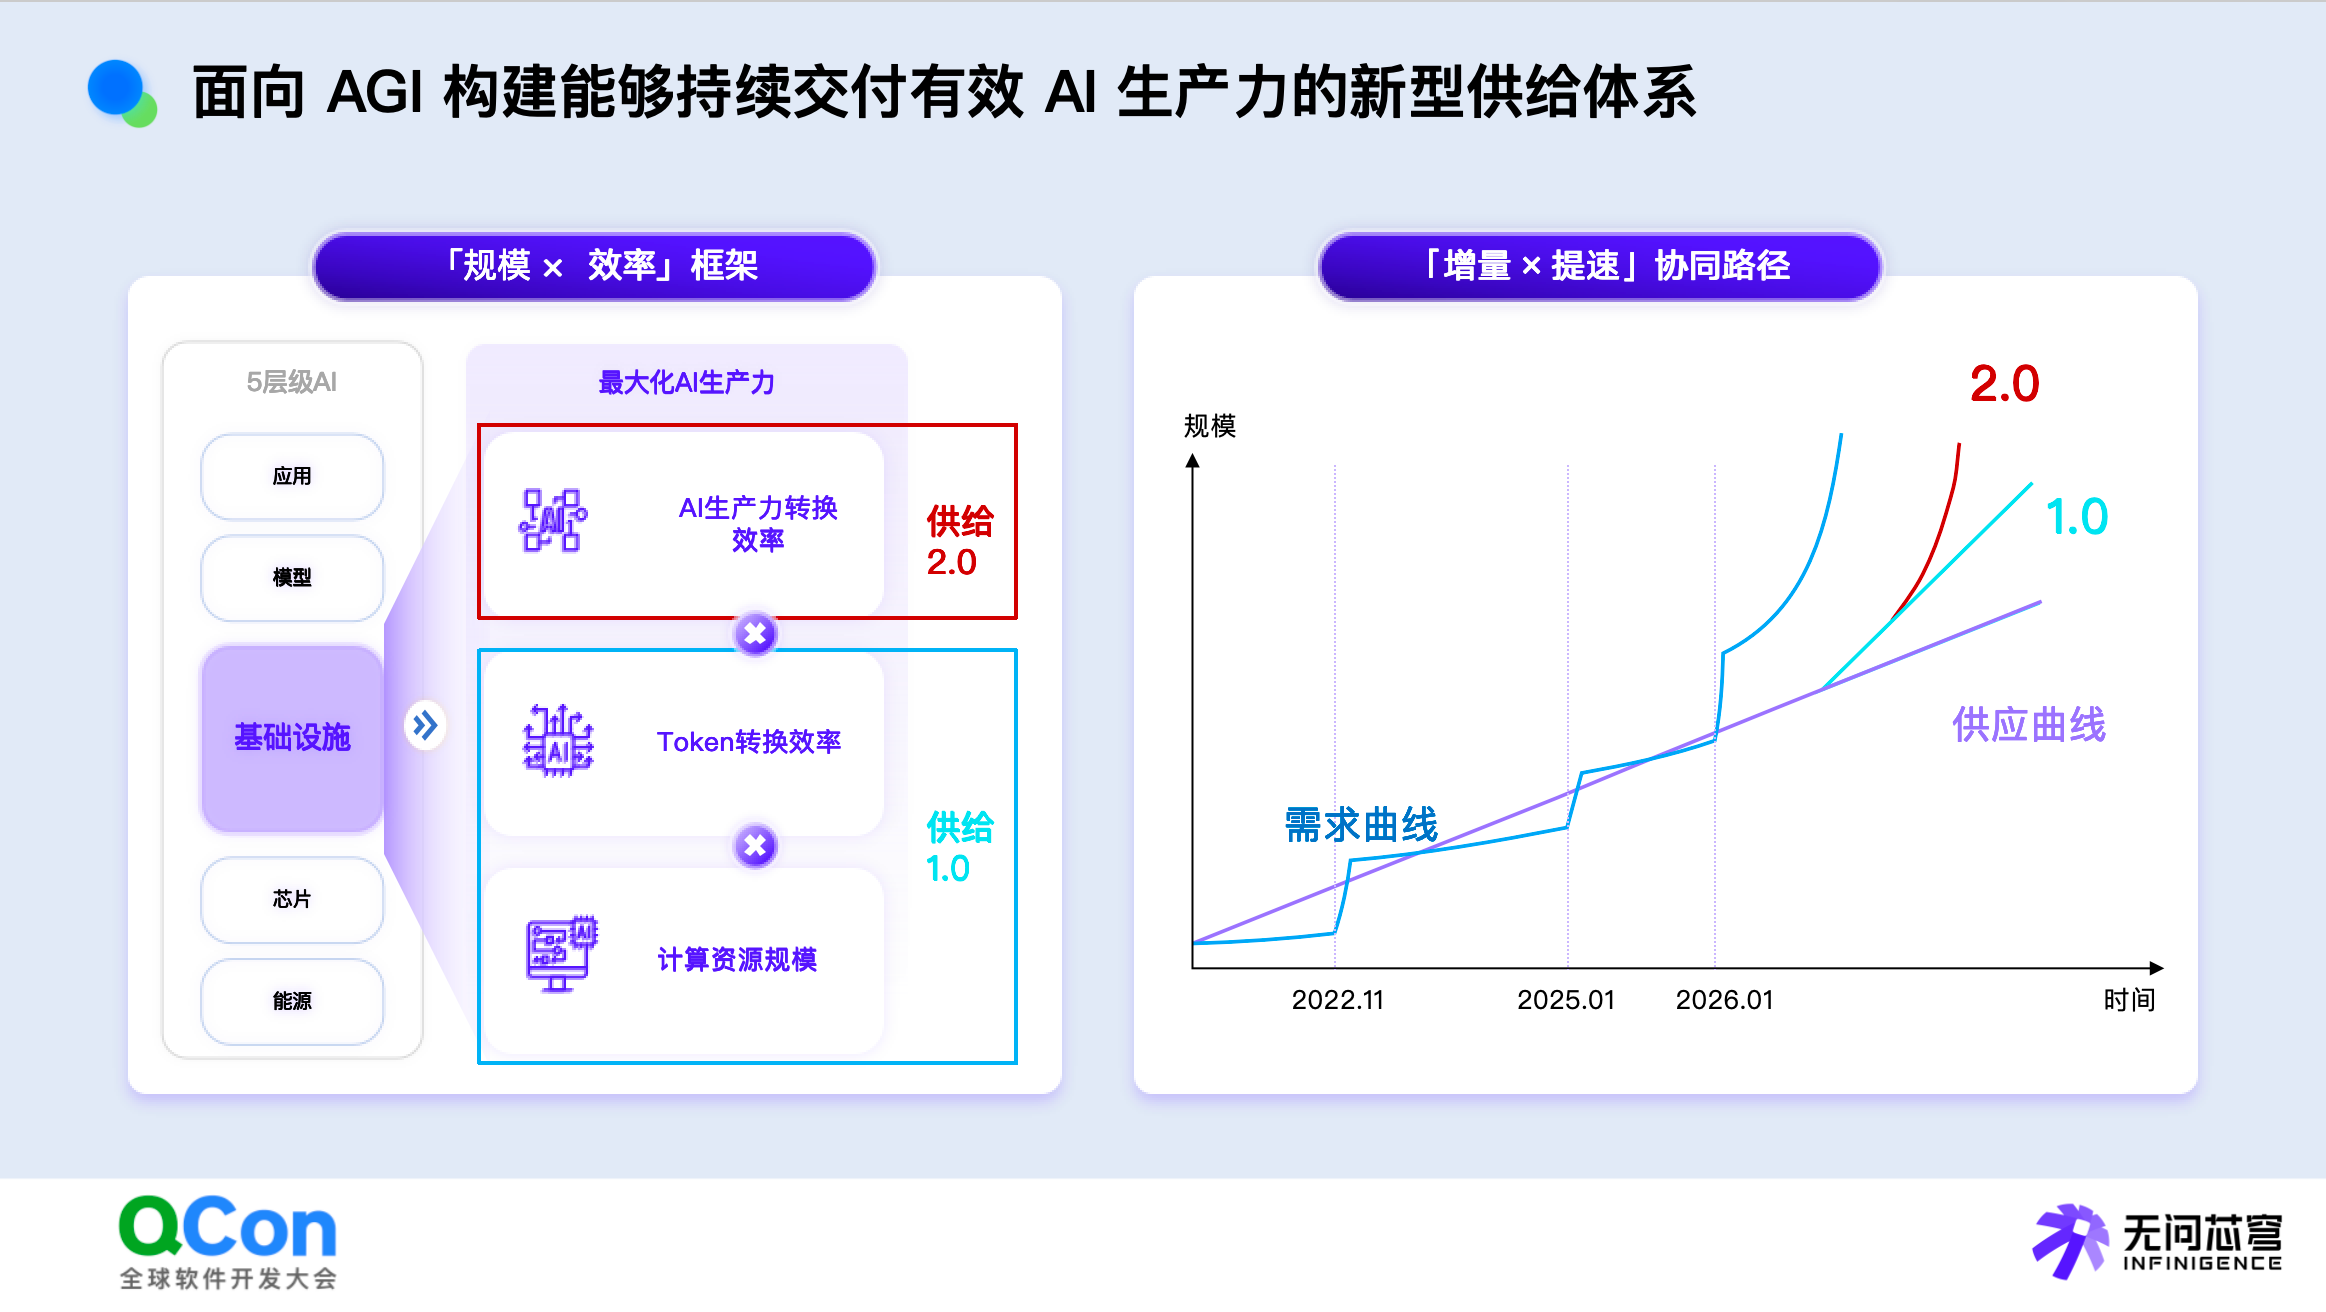
从“生产更多 Token”拓展到“以更低成本交付更多有效任务成果”,无问芯穹正在以“规模 × 效率”为锚点,通过持续进化的Agentic Infra,撬动Token供给“量”与“速”的乘积效应。面向 AGI,基础设施不仅要承载智能,更要推动智能持续转化为生产力。未来,无问芯穹将继续探索能源、芯片、基础设施、模型与应用的深度协同,以技术创新构建能够持续演进、持续交付有效 AI 生产力的新型供给体系,为 AGI 时代的到来夯实基础设施底座。
鸣谢:Humanize社区(https://github.com/humanfia/humanize)