RLinf 是由无问芯穹和清华大学联合北京中关村学院等多家机构共同推出,是全球首个面向具身智能的大规模强化学习训练开源框架,RLinf 系列成果发表于 OSDI、RSS、NeurIPS、CoRL 等重要会议,被多所世界顶尖高校学术机构以及全球领先的 AI 芯片和具身智能等企业广泛采用。框架专为通过强化学习对具身大模型进行后训练而设计,独创了 M2Flow 编程范式与混合式执行模式,实现系统提速超120%、模型性能跃升40%~60%。
近日,昆仑芯基于 RLinf 完成 Kunlunxin XPU 后端适配,并在 P800 平台上实现单节点、多节点以及训练与仿真分离、训练与推理分离等多种运行模式验证。 此次适配进一步验证了 RLinf 在国产算力平台上的兼容性与扩展能力,为具身智能开发者提供更多元的算力选择。
以下内容转载自昆仑芯科技,详细介绍了本次适配验证的技术实现与测试结果。
接入主流开源框架,拓展应用支持
昆仑芯基于 RLinf 模块化的硬件接口设计,通过标准插件方式完成 Kunlunxin XPU 后端接入,无需修改框架既有实现,即可将昆仑芯算力纳入 RLinf 运行体系,进一步打通设备管理、任务调度与分布式通信等关键环节。
在设备管理与任务调度方面,昆仑芯完成 Kunlunxin XPU 设备发现、资源配置及 Ray 调度适配,确保训练任务能够准确使用实际分配的算力资源;在分布式通信方面,以 XCCL 作为通信后端,支持 AllReduce、AllGather 等多卡集合通信,打通单节点及多节点强化学习任务的运行基础。
基于上述适配,昆仑芯 P800 能够在 RLinf 框架下开展单节点、多节点以及训练、仿真、推理分离等多种运行模式验证,为具身智能强化学习任务提供更加灵活的国产算力支持。
覆盖多种部署模式,提升资源调度灵活性
具身强化学习涵盖训练、仿真与推理等多个环节,对算力资源的配置方式提出了更高要求。基于 RLinf,昆仑芯 P800 完成多种部署模式的适配验证。
其中,在训练与仿真分离模式下,Actor、Rollout 部署于训练节点,Environment 部署于独立仿真节点,实现训练与仿真资源的独立配置;在训练与推理分离模式下,策略训练与动作生成部署于不同设备,减少不同任务之间的资源竞争。

通过灵活的部署方式,昆仑芯 P800 进一步拓展了具身强化学习场景下的算力组织方式,为不同规模任务提供更加灵活的资源配置能力。
完成 Pi 0.5 适配验证,验证具身强化学习应用能力
在实际任务验证中,昆仑芯 P800 已完成 LIBERO Spatial、Object 和 Goal 等任务配置的适配验证。其中,Pi 0.5 相关配置覆盖单节点 8 卡与双节点 16 卡环境,完成从单节点训练到多节点协同的运行验证。
在 libero_spatial_grpo_openpi_pi05 配置下,昆仑芯 P800 完成 Pi 0.5 模型在 LIBERO Spatial 任务上的强化学习训练与仿真评测。测试结果显示,在第 70 个训练 step,模型任务成功率达到 99.77%,强化训练曲线整体与公开结果呈现相同趋势;相比强化学习训练前,训练后策略成功率提升 12.27%。
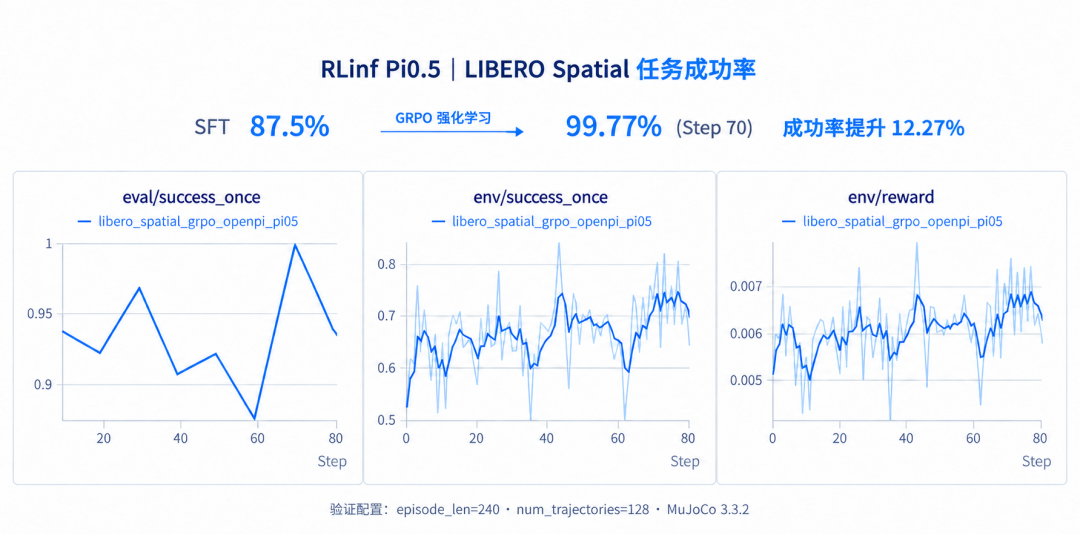
从训练到仿真评测,昆仑芯 P800 已跑通基于 RLinf 的完整强化学习流程。开发者可以沿用 RLinf 现有开发方式,在昆仑芯平台完成模型训练、策略优化与任务评测,为进一步开展具身智能强化学习研究与应用提供算力支撑。
优化分布式通信,降低多节点同步开销
在具身强化学习任务中,模型权重需要在训练与 Rollout 等环节之间频繁传递,通信效率直接影响整体运行效率。针对多节点训练中的权重同步开销,基于 P800 平台进一步优化跨节点通信链路,通过引入混合通信方案提升权重传递效率。
测试结果显示,单节点首个 step 的权重同步耗时由 14.710 秒降至 3.006 秒,多节点首个 step 由 299.0 秒降至 6.510 秒;在后续训练 step 中,相比仅使用 Gloo,混合通信方案仍可节省约 40 秒的权重同步时间。
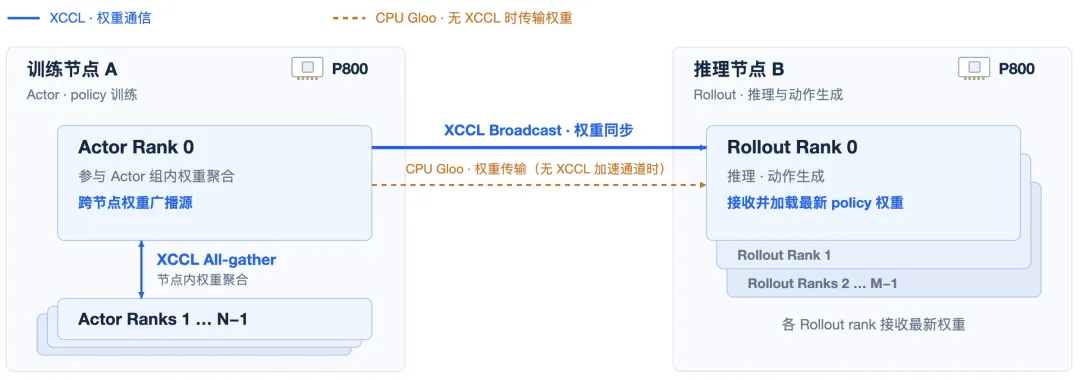
上述结果表明,经过通信链路优化,昆仑芯 P800 能够有效降低多节点强化学习任务中的同步开销,为具身智能强化学习的分布式运行提供更高效的通信支撑。
开发者可以参考下述链接,进行体验:
https://github.com/RLinf/RLinf/blob/release/v0.4/docker/README.md#building-for-kunlunxin-kunlun